Представлен AgenticBBO-Bench: бенчмарк ИИ-агентов для оптимизации «чёрного ящика»
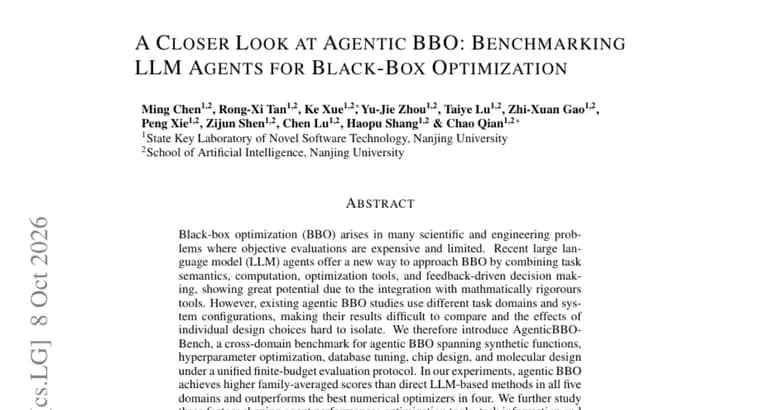
Оптимизация «чёрного ящика» (black-box optimization, BBO) возникает во многих научных и инженерных задачах, где вычисление целевой функции дорого и число таких вычислений ограничено. Недавние агенты на основе больших языковых моделей (LLM) предлагают новый подход: они сочетают понимание смысла задачи, вычисления, инструменты оптимизации и принятие решений по обратной связи. Авторы работы отмечают, что за счёт интеграции с математически строгими инструментами такие агенты показывают большой потенциал.
Проблема в том, что существующие исследования агентной BBO используют разные предметные области и разные конфигурации систем. Из-за этого их результаты трудно сравнивать, а вклад отдельных проектных решений сложно выделить. Чтобы это исправить, авторы представили AgenticBBO-Bench, кросс-доменный бенчмарк для агентной BBO. Он охватывает синтетические функции, оптимизацию гиперпараметров, настройку баз данных, проектирование микросхем и дизайн молекул и использует единый протокол оценки с ограниченным бюджетом вычислений.
В экспериментах агентная BBO получила более высокие баллы (усреднённые по семействам методов), чем прямые методы на основе LLM, во всех пяти областях, а лучшие численные оптимизаторы превзошла в четырёх из пяти.
Далее авторы изучили три фактора, определяющих качество работы агента: инструменты оптимизации, информацию о задаче и априорные знания, а также роль LLM в процессе поиска. Выводы такие: дополнительные численные инструменты не всегда улучшают результат; смысловое описание задачи в целом полезно, а более специфичные априорные сведения менее надёжны; численные оптимизаторы способны эффективно «подхватывать» выигрыш от траекторий поиска, заданных агентом.
Наконец, внутри AgenticBBO-Bench авторы добавили «передовое испытание» из пяти задач и оценили семь LLM в среде агента Codex. По соотношению качества и стоимости на парето-фронте среди оценённых моделей оказались GPT-6 Astra и DeepSeek-V4.1-Flash. Код бенчмарка опубликован на GitHub: github.com/lamda-bbo/agentic-bbo.
Ключевые факты
- AgenticBBO-Bench, единый бенчмарк для агентной оптимизации «чёрного ящика» из пяти областей: синтетические функции, гиперпараметры, настройка баз данных, проектирование микросхем и дизайн молекул; протокол оценки с ограниченным бюджетом.
- Агентный подход получил более высокие усреднённые по семействам баллы, чем прямые методы на основе LLM, во всех пяти областях и превзошёл лучшие численные оптимизаторы в четырёх.
- Три изученных фактора: дополнительные численные инструменты не дают стабильного выигрыша, смысл задачи полезен, а узкие априорные знания менее надёжны; численные оптимизаторы могут усилить результаты, найденные агентом.
- В «передовом испытании» из пяти задач семь LLM оценили в среде Codex; на парето-фронте качества и стоимости оказались GPT-6 Astra и DeepSeek-V4.1-Flash.
- Код бенчмарка выложен на GitHub (lamda-bbo/agentic-bbo).
Почему это важно
Агентные подходы к оптимизации «чёрного ящика» исследуют в разных областях и с разными настройками, поэтому их результаты трудно сопоставить, а влияние отдельных решений не отделить от прочих. Единый бенчмарк с общим протоколом и ограниченным бюджетом вычислений даёт общую основу для сравнения. Первые результаты на нём показывают, что агенты на основе LLM получают более высокие баллы, чем прямые LLM-методы, во всех пяти областях и в четырёх из них превосходят лучшие численные оптимизаторы.
Кому это важно
Исследователям и инженерам, которые решают задачи с дорогими и редкими вычислениями целевой функции: подбор гиперпараметров, настройка баз данных, проектирование микросхем, дизайн молекул. Также работа будет полезна тем, кто строит агентов с инструментами оптимизации и хочет сравнивать свои конфигурации на общей основе.
Как это применить
Код бенчмарка доступен на GitHub (github.com/lamda-bbo/agentic-bbo), так что собственного агента или конфигурацию можно прогнать на тех же пяти областях. Из выводов авторов для практики: не стоит рассчитывать, что добавление численных инструментов всегда улучшит результат; описание смысла задачи в целом помогает, а более специфичные априорные сведения менее надёжны; численный оптимизатор можно подключать поверх траекторий поиска, найденных агентом.
Можно ли доверять
Это описание работы по её собственной аннотации: выводы принадлежат авторам, а сравнения в ней качественные (выше, превосходит), без конкретных значений баллов и размеров выигрыша. Сильная сторона, открытый код, по которому результаты можно перепроверить. В аннотации не указано, прошла ли работа рецензирование.
Риски и подводные камни
Из аннотации не видно величины преимущества агентов: числа баллов и отрывов не приведены. Не названо, в какой именно из пяти областей агентная BBO не обошла лучшие численные оптимизаторы. Из семи LLM «передового испытания» названы только две, а данных о стоимости и качестве моделей на парето-фронте нет. Выводы получены в рамках протокола с ограниченным бюджетом и на пяти выбранных областях, поэтому переносить их на другие задачи стоит с осторожностью.