Исследователи переделали Llama 3 8B и Qwen3 8B Base в байтовые модели: менее 1% бюджета
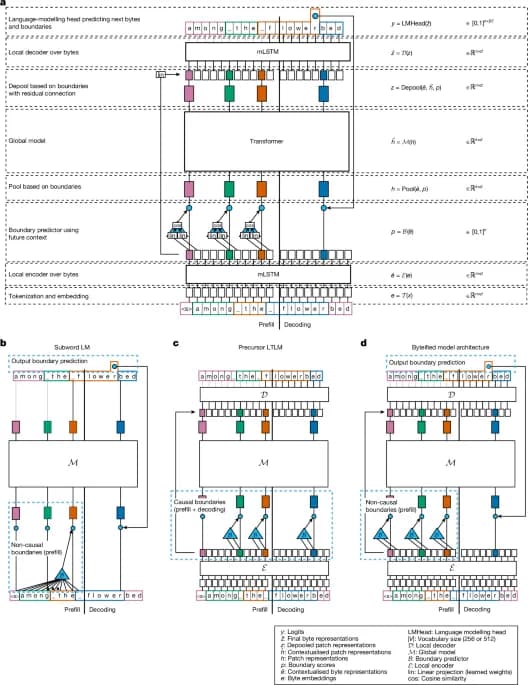
Авторы статьи на nature.com предлагают способ, который называют «байтификацией» (byteification): уже обученную языковую модель, работающую с токенами-подсловами (subword tokenization, токенизация на части слов), переделывают в модель, которая оперирует напрямую байтами текста в кодировке UTF-8. Для этого используется двухэтапная процедура конверсии с минимальным дообучением. По словам авторов, на неё ушло менее 1% типичного бюджета предобучения: 49,1 млрд токенов в сумме.
Из открытых моделей получены Bolmo 7B и Bolmo 1B (из Olmo 3 7B и OLMo 2 1B), Bwen 8B (из Qwen3 8B Base) и Blama 8B (из Llama 3 8B). Авторы утверждают, что байтифицированные модели в среднем превзошли все ранее опубликованные байтовые модели сопоставимого размера. В качестве примера приводится Bolmo 7B: +16,5% абсолютного улучшения на STEM-задачах относительно BLT 7B, обученной с нуля (бенчмарк и метрика в доступном тексте не названы). Кроме того, Bolmo 7B заметно превзошла исходную Olmo 3 в понимании символов и оказалась лучше в некоторых сценариях программирования. Bwen 8B обошла Bolmo 7B и по качеству приблизилась к исходной Qwen, а иногда и превосходила её.
Мотивация такова. Токенизация на подслова скрывает мелкие детали: модели хуже понимают отдельные символы, что мешает на научных данных вроде программного кода и биологических последовательностей. Кроме того, по утверждению авторов, такие модели склонны к определённым ответам в зависимости от того, как токенизирован запрос, ограничены размером словаря (на практике это ведёт к ориентации на английский) и потенциально неоптимально распределяют вычисления. Байтовые модели эти ограничения обходят, но, как пишут авторы, до сих пор отставали по качеству, и все ведущие модели по-прежнему целиком опираются на подсловную токенизацию. Авторы выдвигают гипотезу: причина в том, что байтовые модели обычно обучают с нуля, а угнаться за быстро развивающимся обучением подсловных моделей без больших инвестиций невозможно.
Архитектура устроена так. Локальный энкодер по байтам строит их контекстуальные представления, предиктор границ решает, где поставить границу патча, байты между границами объединяются в патчи, большая глобальная модель на трансформере обрабатывает патчи, затем результат разворачивается обратно в байты локальным декодером, который предсказывает следующий байт. Для локальных моделей выбраны слои mLSTM (matrix long short-term memory): в экспериментах авторов они сохраняли высокое качество при высокой пропускной способности. Главное отличие от прежних архитектур, некаузальное (учитывающее будущий контекст) предсказание границ патчей: предиктор использует до 1 байта будущего контекста, чего достаточно, чтобы в основном повторять поведение подсловного токенизатора. Авторы показывают это на примере: токенизатор решает, быть ли «_Wor» отдельным токеном, глядя на следующий символ («_Hello_Wor!» против «_Hello_World!»), а прежние предсказатели границ смотреть вперёд не могли.
Ещё два заявленных результата: байтифицированные модели можно дополнительно ускорять, обучая их с большим числом байтов на патч (в подсловных моделях это возможно лишь в ограниченной степени), а готовые компоненты экосистемы исходной модели можно использовать для адаптации байтифицированной без дополнительных затрат на обучение. Эффективность по энергии и стоимости развёртывания авторы называют потенциальным преимуществом, а не измеренным.
Важная оговорка: доступный текст обрывается в разделе Main, поэтому методы, полные таблицы результатов и ограничения здесь не видны.
Ключевые факты
- Метод «байтификации» переделывает готовые подсловные языковые модели в байтовые двухэтапной процедурой: менее 1% типичного бюджета предобучения (49,1 млрд токенов в сумме).
- Получены Bolmo 7B и Bolmo 1B (из Olmo 3 7B и OLMo 2 1B), Bwen 8B (из Qwen3 8B Base) и Blama 8B (из Llama 3 8B).
- По словам авторов, байтифицированные модели в среднем превзошли все ранее опубликованные байтовые модели сопоставимого размера; у Bolmo 7B +16,5% абсолютного улучшения на STEM-задачах над BLT 7B.
- Главное архитектурное отличие, предсказание границ патчей с учётом до 1 байта будущего контекста вместо чисто причинного (только по прошлому).
- Bwen 8B подошла близко к исходной Qwen и иногда её превосходила; выгоды по энергии и стоимости развёртывания авторы называют потенциальными.
Почему это важно
Все ведущие языковые модели по-прежнему целиком используют подсловную токенизацию, а байтовые модели не получили широкого распространения: обучать их с нуля и тягаться с быстро улучшающимися подсловными моделями слишком дорого. Авторы предлагают другой путь: не строить байтовую модель с нуля, а переделать уже обученную, потратив менее 1% типичного бюджета предобучения. Если заявленные результаты подтвердятся независимо, это снимает главное препятствие для байтовых моделей, цену входа. Авторы заявляют, что их результаты снимают давний барьер производительности для сквозного байтового моделирования.
Кому это важно
Исследователям языковых моделей и токенизации: метод позволяет быстро проверять байтовые архитектуры на базе сильных открытых моделей. Тем, кто работает с научными данными (код, биологические последовательности), где значение зависит от отдельных символов или байтов. Разработчикам многоязычных систем: авторы связывают подсловную токенизацию с ориентацией на английский из-за ограниченного словаря.
Как это применить
Прямой инструкции для практиков в доступном тексте нет. Из него видно, что исходными моделями служили открытые Olmo 3 7B, OLMo 2 1B, Qwen3 8B Base и Llama 3 8B, а процедура состоит из двух этапов обучения на 49,1 млрд токенов в сумме. Заявлений о публичной доступности моделей Bolmo, Bwen и Blama и об их лицензиях в видимой части статьи нет. Авторы также пишут, что компоненты экосистемы исходной модели можно использовать для адаптации байтифицированной модели без дополнительных затрат на обучение.
Можно ли доверять
Это научная статья на nature.com, а все количественные утверждения, заявления самих авторов. Доступный текст обрывается посреди раздела Main, поэтому методы, полные таблицы и ограничения не видны. Для прироста +16,5% на STEM-задачах не названы бенчмарк и метрика, для Blama 8B и Bolmo 1B числовых результатов в видимой части нет. Формулировки осторожны: «близко к» исходной модели и «иногда превосходит», а не превосходство по всем показателям.
Риски и подводные камни
Эффективность по энергии и стоимости развёртывания авторы называют лишь потенциальным преимуществом, измеренной экономии в видимом тексте нет, как и цифр скорости вывода и затрат в GPU-часах или деньгах. Гипотеза о том, что отставание байтовых моделей объясняется обучением с нуля, остаётся именно гипотезой авторов. Качество байтифицированной модели «близко к» исходной, а не равно ей, и в части задач (например, в программировании) улучшение отмечено лишь «в некоторых сценариях».
«Наши результаты снимают давний барьер производительности для сквозного байтового языкового моделирования.»
— авторы статьи