Представлен OmniCapBench: тест описаний видео со звуком для мультимодальных нейросетей
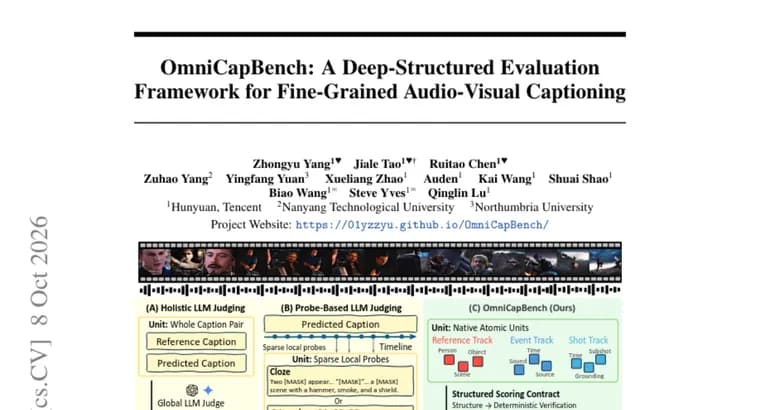
Авторы работы представили OmniCapBench (Omni-Video Caption Benchmark), бенчмарк для оценки того, как мультимодальные большие языковые модели (MLLM) описывают видео вместе со звуком. Мотив: такие модели быстро движутся к непрерывному аудиовизуальному рассуждению, и нужны оценки, которые покажут пределы их возможностей. Описание видео со звуком авторы считают удобной диагностической задачей, но существующие бенчмарки, по их словам, упираются в связанный компромисс: оценка всего описания целиком даёт охват, но не позволяет локализовать ошибку; локальные проверки дают локализацию, но не дают охвата; а свободные LLM-судьи вносят нестабильность.
OmniCapBench переопределяет задачу: вместо свободного текста цель предсказания, наборы атомарных, проверяемых единиц оценки. Они разложены по трём трекам: ссылки на сущности (entity references), визуальные планы (visual shots) и звуковые события (audio events). Такая структура, как утверждают авторы, позволяет оценивать надёжно: детерминированными проверками ограничений и локальными семантическими сравнениями с помощью LLM.
Бенчмарк построен на 786 плотно размеченных видео. По заявлению авторов, он эффективно различает типы перцептивных ошибок MLLM: сбои временной привязки (temporal grounding), дрейф идентичности (identity drift), межмодальное рассогласование (cross-modal misalignment) и галлюцинированные описания.
Главный вывод оценки передовых MLLM: сильное локальное восприятие, но слабое долгосрочное аудиовизуальное рассуждение, особенно в части дрейфа идентичности и межмодального рассогласования. Авторы называют результат детальной дорожной картой развития омнимодальных моделей.
Ключевые факты
- OmniCapBench, бенчмарк описания видео со звуком, построенный на 786 плотно размеченных видео.
- Вместо оценки свободного текста модель проверяют по наборам атомарных, проверяемых единиц в трёх треках: сущности, визуальные планы и звуковые события.
- Оценка сочетает детерминированные проверки ограничений с локальными семантическими сравнениями на основе LLM.
- Бенчмарк, по словам авторов, различает сбои временной привязки, дрейф идентичности, межмодальное рассогласование и галлюцинированные описания.
- Передовые MLLM, по данным авторов, хорошо воспринимают локальные детали, но слабы в долгом аудиовизуальном рассуждении.
Почему это важно
Мультимодальные модели всё чаще работают с видео и звуком одновременно, а способы проверить, насколько точно они описывают увиденное и услышанное, остаются грубыми. По описанию авторов, текущие подходы вынуждают выбирать между охватом и точностью локализации ошибки, а свободные LLM-судьи нестабильны. OmniCapBench пытается снять этот компромисс, разложив описание на проверяемые единицы, и показывает, где именно ломаются модели: на долгих отрезках, при удержании идентичности и при согласовании звука с картинкой.
Кому это важно
Исследователям и разработчикам мультимодальных и омнимодальных моделей, которым нужна диагностика ошибок, а не единая общая оценка. Командам, оценивающим качество автоматических описаний видео со звуком, как пример структуры оценки через атомарные единицы вместо свободного судейства.
Как это применить
Практический сценарий, диагностика собственной модели по трём трекам (сущности, визуальные планы, звуковые события) и по типам ошибок: временная привязка, дрейф идентичности, межмодальное рассогласование, галлюцинации. Идея разложения описания на проверяемые единицы с детерминированными проверками и локальным LLM-сравнением может быть полезна и при построении других оценок. Сведений о доступности кода и данных в аннотации не указано, поэтому ориентироваться стоит на публикацию работы.
Можно ли доверять
Все утверждения, заявления самих авторов в аннотации работы, независимо они не подтверждены. В аннотации не названы авторы и организации, не перечислены конкретные оценённые модели и не приведены числовые результаты, поэтому проверить вывод о слабости передовых MLLM по этому тексту нельзя. Достоверно известны лишь устройство бенчмарка (три трека) и объём данных (786 видео).
Риски и подводные камни
Локальные семантические сравнения опираются на LLM, но в аннотации не сказано, какая именно модель используется, значит, остаточная зависимость от судьи сохраняется. Не указаны число единиц оценки, число разметчиков и общая длительность видео, так что судить о масштабе и репрезентативности набора трудно. Выводы о «передовых» моделях сформулированы в общем виде, без названий и цифр, и обобщать их на конкретные продукты не следует.