Opera: критик для кодинг-агентов добавляет до 15 п.п. решённых задач
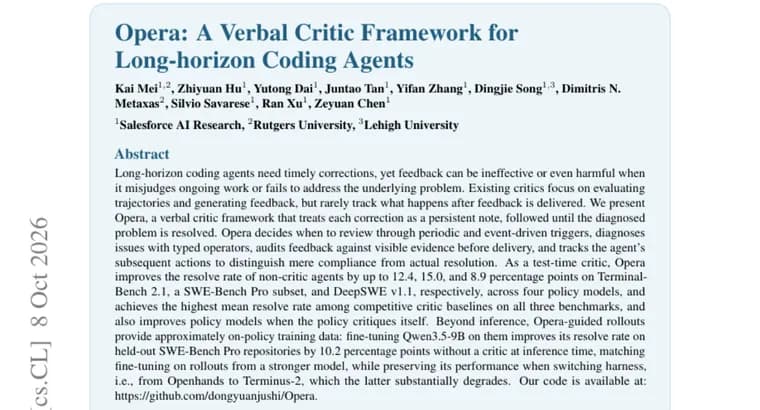
Статья посвящена тому, как корректировать работу кодинг-агентов, решающих длинные многошаговые задачи. Авторы исходят из того, что таким агентам нужны своевременные поправки, но обратная связь бывает неэффективной и даже вредной: когда критик неверно оценивает текущую работу или не затрагивает настоящую причину проблемы. Существующие критики, по словам авторов, сосредоточены на оценке траекторий и генерации замечаний, но почти не следят за тем, что происходит после того, как замечание доставлено.
Ответ авторов, фреймворк Opera, «словесный» критик (обратная связь формулируется текстом), который трактует каждую поправку как постоянную заметку: за ней следят, пока диагностированная проблема не будет решена. Opera сама решает, когда проводить проверку, по периодическим и событийным триггерам; диагностирует проблемы с помощью типизированных операторов; перед отправкой сверяет замечание с видимыми доказательствами; и отслеживает последующие действия агента, чтобы отличить простое выполнение указания от реального решения проблемы.
В роли критика на этапе тестирования (test-time critic) Opera, как сообщают авторы, повышает долю решённых задач (resolve rate) у агентов без критика на величины до 12,4, 15,0 и 8,9 процентного пункта на Terminal-Bench 2.1, подмножестве SWE-Bench Pro и DeepSWE v1.1 соответственно; результаты приведены для четырёх базовых моделей (policy models). Среди сильных конкурирующих критиков Opera показывает наивысшую среднюю долю решённых задач на всех трёх бенчмарках. Кроме того, она улучшает результаты и тогда, когда модель критикует саму себя.
Вторая часть работы, обучение. Прогоны (rollouts), проведённые под руководством Opera, дают примерно «он-полисные» обучающие данные (близкие к распределению действий самой модели). Дообучение Qwen3.5-9B на них повышает долю решённых задач на отложенных репозиториях SWE-Bench Pro на 10,2 п.п., причём без критика во время инференса. По утверждению авторов, это соответствует результату дообучения на прогонах более сильной модели, а при смене обвязки (harness) с Openhands на Terminus-2, которая заметно ухудшает результаты, модель сохраняет свою результативность. Код опубликован в репозитории dongyuanjushi/Opera на GitHub.
Ключевые факты
- Opera, словесный критик для долгих кодинг-задач: каждая поправка становится постоянной заметкой, за выполнением которой следят, пока проблема не решена.
- Критик сам выбирает моменты проверки (периодические и событийные триггеры), диагностирует проблемы типизированными операторами и сверяет замечание с видимыми доказательствами перед отправкой.
- Как критик на этапе тестирования Opera повышает долю решённых задач у агентов без критика на величины до 12,4 (Terminal-Bench 2.1), 15,0 (подмножество SWE-Bench Pro) и 8,9 п.п. (DeepSWE v1.1) на четырёх базовых моделях.
- Дообучение Qwen3.5-9B на прогонах под руководством Opera даёт +10,2 п.п. на отложенных репозиториях SWE-Bench Pro без критика при инференсе.
- Код доступен на GitHub: dongyuanjushi/Opera.
Почему это важно
Кодинг-агенты всё чаще работают над длинными задачами, где нужны своевременные поправки, а обратная связь бывает неэффективной или даже вредной. Работа указывает на конкретную слабость привычных критиков: они выдают замечание и на этом останавливаются, не проверяя, привело ли оно к решению проблемы. Идея Opera, отслеживать судьбу каждой поправки и отличать формальное выполнение указания от реального исправления. Вторая важная часть, критик используется не только на лету, но и как источник обучающих данных, близких к распределению действий самой модели.
Кому это важно
Прежде всего тем, кто строит и оценивает кодинг-агентов и оболочки для них: исследователям агентных систем и командам, которые работают с бенчмарками вроде Terminal-Bench, SWE-Bench Pro и DeepSWE. Также интересно тем, кто дообучает небольшие открытые модели для программирования: в работе показан пример с Qwen3.5-9B.
Как это применить
Авторы выложили код в репозитории dongyuanjushi/Opera на GitHub. Из описания следуют два сценария: подключить Opera как критика, который наблюдает за агентом во время работы, либо использовать прогоны под её руководством как обучающие данные для дообучения модели, тогда критик при инференсе не нужен. Подробности подключения в аннотации не раскрыты, их нужно смотреть в репозитории.
Можно ли доверять
Все цифры взяты из аннотации статьи и представляют собой заявления самих авторов; независимой проверки в материале нет. Значения 12,4, 15,0 и 8,9 п.п., это максимальные приросты («до») по четырём базовым моделям, а не средние или типичные. Абсолютные значения доли решённых задач (ни базовые, ни с Opera) в аннотации не приведены, только приросты в процентных пунктах. Четыре базовые модели не названы; не названа и «более сильная модель», с которой сравнивается дообучение. Для SWE-Bench Pro используется подмножество, а прирост 10,2 п.п. измерен на отложенных репозиториях этого бенчмарка.
Риски и подводные камни
Сами авторы подчёркивают, что обратная связь может быть вредной, если критик неверно оценивает ход работы, поэтому в Opera есть сверка замечаний с доказательствами, но эффективность этой защиты подтверждена только заявленными авторами результатами. В аннотации не указаны затраты на работу Opera: стоимость, задержки и вычислительные накладные расходы не названы, так что оценить практическую цену внедрения по этому тексту нельзя. Результаты получены на конкретных бенчмарках и обвязках (Openhands, Terminus-2); перенос на другие задачи и среды не обсуждается.