Диффузию и авторегрессию описали как пути на одной решётке
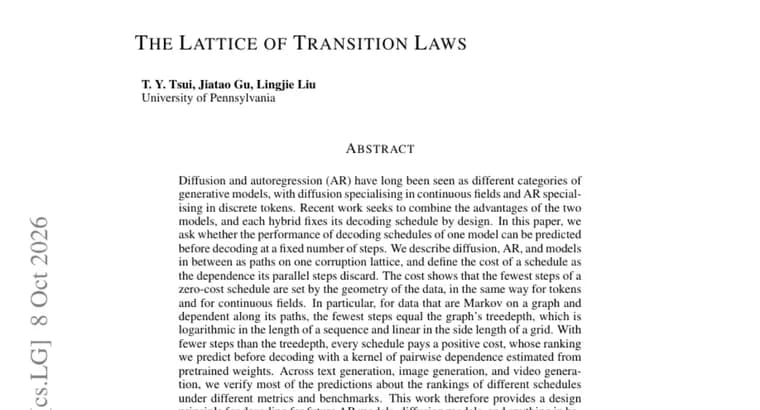
Диффузионные и авторегрессионные (AR) модели давно считались разными классами генеративных моделей: диффузия работает с непрерывными полями, авторегрессия, с дискретными токенами. Недавние гибриды пытаются соединить достоинства обоих подходов, но каждый из них фиксирует расписание декодирования заранее, на этапе проектирования.
Авторы статьи задаются вопросом: можно ли предсказать качество расписаний декодирования одной модели до самого декодирования при фиксированном числе шагов. Для этого диффузию, авторегрессию и всё, что лежит между ними, они описывают как пути на одной «решётке порчи» (corruption lattice). Стоимость расписания определяется как зависимость, которую отбрасывают его параллельные шаги.
Из этой стоимости следует, что наименьшее число шагов расписания с нулевой стоимостью задаётся геометрией данных, одинаково для токенов и для непрерывных полей. Для данных, которые марковские на графе и зависимы вдоль его путей, это число равно treedepth графа (древесной глубине графа): она растёт логарифмически от длины последовательности и линейно от длины стороны сетки.
Если шагов меньше, чем treedepth, любое расписание платит положительную цену. Рейтинг расписаний по этой цене авторы предсказывают до декодирования с помощью ядра попарной зависимости, оцениваемого по весам предобученной модели. На генерации текста, изображений и видео, по словам авторов, подтвердилась большая часть предсказаний о рейтинге расписаний при разных метриках и бенчмарках. Авторы подают работу как принцип проектирования декодирования для будущих авторегрессионных, диффузионных и промежуточных моделей. Код опубликован на GitHub.
Ключевые факты
- Диффузия, авторегрессия и промежуточные модели описаны как пути на одной «решётке порчи» (corruption lattice).
- Стоимость расписания декодирования, зависимость, которую отбрасывают его параллельные шаги; минимальное число шагов с нулевой стоимостью задаёт геометрия данных.
- Для данных, марковских на графе и зависимых вдоль путей, это число равно treedepth графа: логарифм от длины последовательности и линейная зависимость от стороны сетки.
- Рейтинг расписаний предсказывают до декодирования по ядру попарной зависимости из весов предобученной модели; на тексте, изображениях и видео проверено большинство предсказаний.
- Код опубликован на GitHub.
Почему это важно
Гибридные модели на стыке диффузии и авторегрессии обычно жёстко фиксируют расписание декодирования, и выбор между расписаниями делается эмпирически. Статья предлагает единый язык для обоих классов моделей и заявляет, что лучшее расписание можно оценить заранее, а нижняя граница числа шагов определяется структурой данных, а не конкретной архитектурой. Это теоретическая работа: она не обещает готового ускорения, а предлагает принцип проектирования декодирования.
Кому это важно
Прежде всего исследователям генеративных моделей, которые работают с диффузионными, авторегрессионными и гибридными схемами декодирования, а также тем, кто выбирает расписания параллельного декодирования для текста, изображений или видео. Для широкой аудитории материал слишком специальный.
Как это применить
Практический вход один: авторы опубликовали код на GitHub (репозиторий The-Lattice-of-Transition-Laws). По описанию, рейтинг расписаний оценивается по ядру попарной зависимости, полученному из весов предобученной модели, то есть до запуска самого декодирования. Условия использования кода и требования к вычислениям в аннотации не приведены.
Можно ли доверять
Пересказ основан только на аннотации статьи. Все утверждения принадлежат самим авторам. Они пишут, что подтвердилась «большая часть» предсказаний; доля подтверждённых предсказаний не названа, как и то, какие из них не сбылись. Числовых результатов, названий конкретных моделей и бенчмарков в аннотации нет, поэтому оценить силу эмпирической проверки по ней нельзя.
Риски и подводные камни
Точный результат про treedepth сформулирован для данных, марковских на графе и зависимых вдоль его путей, это сильное допущение, и насколько оно выполняется для реальных текстов, изображений и видео, из аннотации не видно. Подтверждена лишь большая часть предсказаний, не все. Заявление касается предсказания рейтинга расписаний и принципа проектирования; о том, что подход даёт более быструю или более качественную генерацию на практике, в аннотации не говорится.
«Эта работа даёт принцип проектирования декодирования для будущих авторегрессионных моделей, диффузионных моделей и всего, что находится между ними.»
— из аннотации статьи