Бенчмарк TestPrism: тесты ИИ-агентов набирают 28% по строгой метрике вместо 59,67%
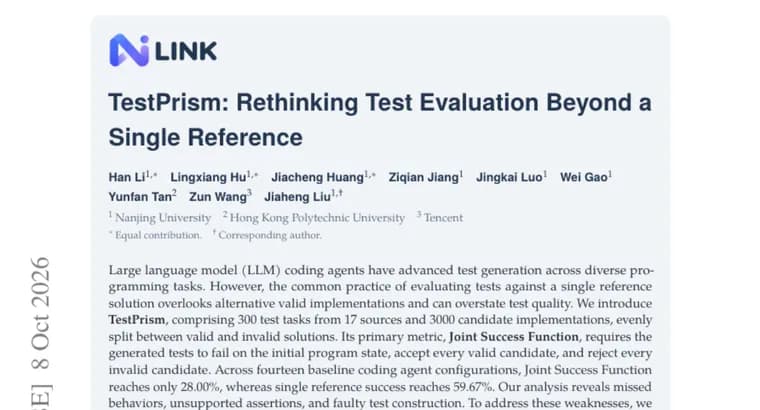
В научной работе представлен TestPrism, бенчмарк для оценки тестов, которые пишут ИИ-агенты для программирования (агенты на базе больших языковых моделей). Авторы исходят из того, что привычная практика, проверять тесты на одном эталонном решении, упускает альтернативные верные реализации и может завышать оценку качества тестов.
TestPrism состоит из 300 тестовых задач из 17 источников и 3000 кандидатных реализаций, поровну разделённых на верные и неверные решения. Главная метрика, Joint Success Function (совместная функция успеха), требует от сгенерированных тестов трёх вещей одновременно: падать на исходном состоянии программы, принимать каждую верную реализацию и отвергать каждую неверную.
На четырнадцати базовых конфигурациях ИИ-агентов для программирования Joint Success Function достигает лишь 28,00%, тогда как успех при проверке по одному эталонному решению составляет 59,67%. В источнике не уточняется, среднее это значение или лучшее среди конфигураций. Анализ авторов выявил пропущенное поведение, неподкреплённые утверждения в проверках (assertions) и ошибки в построении самих тестов.
Чтобы устранить эти слабости, авторы предлагают TestHelix, метод, сочетающий разнородный синтез пар «тест и исправление» с взаимной перекрёстной проверкой (peer cross validation) и рекурсивным самоулучшением (recursive self improvement, RSI). На двух моделях TestHelix повышает Joint Success Function на 8,67-9,00 процентного пункта по сравнению с родными обвязками (native harness), с которыми его сравнивали.
Ключевые факты
- TestPrism, бенчмарк из 300 тестовых задач (17 источников) и 3000 кандидатных реализаций, поровну верных и неверных.
- Главная метрика Joint Success Function требует, чтобы тесты падали на исходном состоянии, принимали все верные и отвергали все неверные реализации.
- На четырнадцати базовых конфигурациях ИИ-агентов метрика достигает 28,00% против 59,67% при проверке по одному эталонному решению.
- Анализ показал пропущенное поведение, неподкреплённые утверждения в проверках и ошибки построения тестов.
- Метод TestHelix на двух моделях повышает Joint Success Function на 8,67, 9,00 процентного пункта относительно родных обвязок.
Почему это важно
ИИ-агенты для программирования всё чаще пишут не только код, но и тесты, а качество этих тестов обычно меряют по одному эталонному решению. Работа показывает, что такая оценка может быть завышена: при более строгой проверке результат падает с 59,67% до 28,00%, разрыв более чем вдвое. Если тест принимает не все корректные реализации или пропускает неверные, ему нельзя полностью доверять, даже когда он «проходит» на эталоне.
Кому это важно
Исследователям, которые строят бенчмарки и оценивают ИИ-агентов для программирования; командам, которые используют нейросети для генерации тестов и хотят понимать реальное качество таких тестов; разработчикам инструментов, где тесты служат сигналом для автоматического исправления кода.
Как это применить
Источник не даёт ссылок на код или набор данных, поэтому прямое использование TestPrism по тексту не описано. Практический вывод из самой идеи: оценивать сгенерированные тесты не на одном эталоне, а на наборе верных и неверных реализаций и проверять три условия, падение на исходном состоянии, принятие всех верных и отклонение всех неверных кандидатов. Метод TestHelix описан только в общих чертах: разнородный синтез пар «тест и исправление», взаимная перекрёстная проверка и рекурсивное самоулучшение.
Можно ли доверять
Это описание научной работы, и все цифры приведены самими авторами. В тексте не названы ни авторы с институтами, ни две модели, на которых оценивали TestHelix, ни четырнадцать базовых конфигураций; не сказано, какие именно 8,67 и 9,00 пункта относятся к какой модели. Не уточняется, среднее ли 28,00% и 59,67% или лучшее значение. Описание обрывается на фразе об оценочном наборе TestHelix, так что название этого набора неизвестно.
Риски и подводные камни
Цифра 28,00% относится к очень строгой метрике: тест должен одновременно принять все верные и отвергнуть все неверные реализации, поэтому прямое сравнение с привычными показателями по одному эталону некорректно. Прирост TestHelix указан в процентных пунктах, а исходный уровень для этого сравнения в источнике не назван, так что оценить относительное улучшение нельзя. Также неизвестно, насколько результаты переносятся за пределы 300 задач бенчмарка.