ToolSpace: метод синтеза сред для MCP-агентов поднял Qwen3.6-35B-A3B с 23,0 до 41,0
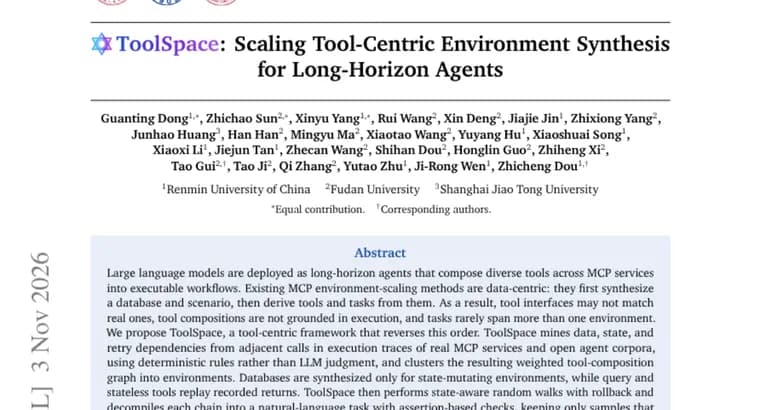
На Hugging Face опубликована аннотация препринта про ToolSpace, метод синтеза сред для ИИ-агентов, которые работают долго и собирают рабочие процессы из разных инструментов сервисов MCP. Авторы утверждают, что существующие методы масштабирования MCP-сред строятся «от данных»: сначала синтезируют базу данных и сценарий, а уже из них выводят инструменты и задачи. Из-за этого интерфейсы инструментов могут не совпадать с настоящими, связки инструментов не подтверждены реальным выполнением, а задачи редко охватывают больше одной среды.
ToolSpace переворачивает этот порядок и начинает с инструментов. Метод извлекает зависимости по данным, по состоянию и по повторным попыткам из соседних вызовов в журналах выполнения (трассах) реальных сервисов MCP и открытых корпусов данных агентов. Делает он это по детерминированным правилам, а не по оценке языковой модели. Полученный взвешенный граф связей между инструментами разбивается на кластеры, это и есть среды. База данных синтезируется только для сред, где инструменты меняют состояние; инструменты-запросы и инструменты без состояния воспроизводят записанные ответы.
Далее ToolSpace запускает случайные блуждания по инструментам с учётом состояния и с откатом, а каждую получившуюся цепочку «декомпилирует» в задачу на естественном языке с проверками на основе утверждений. В набор попадают только те образцы, которые успешно воспроизводятся из начального состояния.
Результаты, о которых заявляют авторы. Конвейер применили к AutomationBench и tau3-Bench Banking и получили более трудные версии Pro: семь передовых моделей на них теряют до 38,2 балла (какие именно модели и на каком тесте, в аннотации не указано, это максимальное падение). На семи тестах долгого использования инструментов ToolSpace поднимает средний балл Qwen3.6-35B-A3B с 23,0 до 41,0, а с обучением с подкреплением, до 43,2. Результат GLM-5.2 вырос с 44,6 до 56,6, что, как сказано в аннотации, сопоставимо с Claude Opus 5. Абляции (отключение отдельных частей метода) показывают, что рёбра графа, подтверждённые выполнением, заметно лучше рёбер, оценённых языковой моделью. Качество продолжает расти с увеличением объёма данных и числа сред.
Ключевые факты
- ToolSpace строит среды для MCP-агентов от инструментов, а не от синтетической базы данных: зависимости извлекаются из журналов выполнения реальных сервисов MCP и открытых корпусов данных агентов по детерминированным правилам.
- На более трудных версиях Pro для AutomationBench и tau3-Bench Banking семь передовых моделей теряют до 38,2 балла.
- Средний балл Qwen3.6-35B-A3B на семи тестах вырос с 23,0 до 41,0 (43,2 с обучением с подкреплением); GLM-5.2, с 44,6 до 56,6, на уровне Claude Opus 5.
- Абляции: рёбра, подтверждённые выполнением, явно лучше рёбер, оценённых языковой моделью; качество растёт с масштабом данных и сред.
Почему это важно
Агенты, которые вызывают много инструментов подряд, нуждаются в больших и реалистичных средах для обучения и проверки. Авторы указывают на слабое место прежних методов: среды, выведенные из синтетических данных, могут не совпадать с настоящими интерфейсами инструментов. ToolSpace опирается на реальные трассы вызовов, а заявленный прирост у открытой модели Qwen3.6-35B-A3B (с 23,0 до 41,0 среднего балла) показывает, что такой подход может заметно влиять на результат.
Кому это важно
Исследователям и командам, которые обучают или оценивают агентов на основе MCP, а также тем, кто строит тесты для долгих цепочек вызовов инструментов. Результаты на AutomationBench и tau3-Bench Banking интересны и тем, кто сравнивает передовые модели: версии Pro оказались заметно труднее исходных.
Как это применить
По аннотации можно понять только общую схему: взять трассы вызовов реальных сервисов MCP, извлечь зависимости детерминированными правилами, кластеризовать граф в среды, синтезировать базы данных только для сред с изменяемым состоянием, сгенерировать задачи случайными блужданиями с откатом и оставить лишь воспроизводимые образцы. Сведений о публикации кода или данных, лицензии и затратах на вычисления в тексте нет, поэтому практическое применение зависит от полной версии статьи.
Можно ли доверять
Это препринт, и всё изложенное здесь взято из его аннотации: цифры, собственные заявления авторов. В аннотации не названы семь передовых моделей и семь тестов (кроме AutomationBench и tau3-Bench Banking, на которых построены версии Pro), а 38,2 балла, максимальное падение, а не типичное. Сопоставимость GLM-5.2 с Claude Opus 5 приведена без числового значения для Claude Opus 5. Независимой проверки результатов в источнике нет.
Риски и подводные камни
Версии Pro для AutomationBench и tau3-Bench Banking построены тем же методом, а о происхождении семи тестов, на которых измерен прирост Qwen3.6-35B-A3B и GLM-5.2, в аннотации не сказано, поэтому перенос на другие задачи неочевиден. В аннотации не описаны ограничения и случаи неудач, а способ обучения варианта с подкреплением не раскрыт. Метод зависит от наличия качественных трасс реальных сервисов MCP и открытых корпусов данных агентов.