Исследование: частое сжатие контекста почти не снижает точность нейросетей
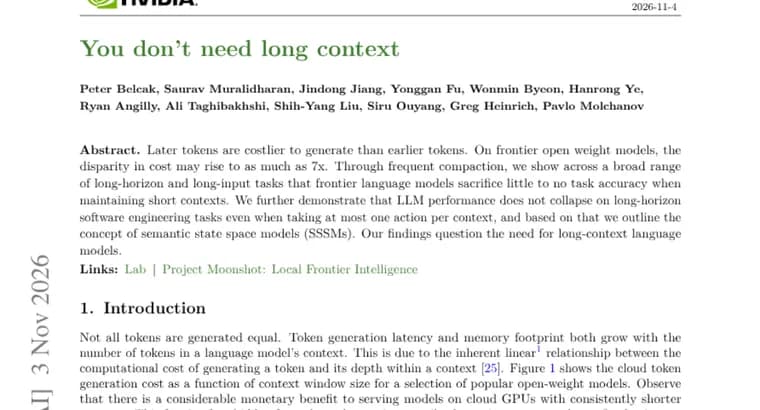
Препринт «You don't need long context» (в переводе, «Длинный контекст вам не нужен») начинается с наблюдения о стоимости генерации: более поздние токены обходятся дороже ранних. На передовых языковых моделях с открытыми весами разрыв в стоимости, по словам авторов, может достигать семикратного. Это верхняя оценка («до 7 раз»), а не типичное значение.
Основной довод работы: если поддерживать короткий контекст за счёт частого сжатия (compaction), то на широком круге задач с длинным горизонтом действий и длинным входом передовые языковые модели теряют мало точности или не теряют её совсем. Конкретных цифр точности, названий моделей и тестовых наборов в аннотации нет.
Отдельный эксперимент касается долгих задач по разработке программного обеспечения. По утверждению авторов, качество работы модели не «обрушивается», даже если за один контекст она делает не более одного действия. На этом результате авторы описывают концепцию семантических моделей пространства состояний (semantic state space models, SSSMs). Что именно это такое, помимо названия, в аннотации не раскрыто.
Итоговый вывод авторов осторожный: их результаты «ставят под вопрос необходимость» языковых моделей с длинным контекстом. Они не заявляют, что такие модели бесполезны. Доступный текст, только аннотация, поэтому методика, масштаб экспериментов и условия сравнения остаются неизвестными.
Ключевые факты
- Более поздние токены дороже в генерации, чем ранние: на передовых моделях с открытыми весами разрыв может доходить до 7 раз (верхняя граница).
- При частом сжатии контекста передовые языковые модели, по утверждению авторов, теряют мало точности или не теряют её на широком круге задач с длинным горизонтом и длинным входом.
- На долгих задачах по разработке ПО качество не «обрушивается», даже когда за контекст делается не более одного действия.
- На этой основе авторы описывают концепцию семантических моделей пространства состояний (SSSMs).
- Вывод: результаты ставят под вопрос необходимость моделей с длинным контекстом, но не отвергают их.
Почему это важно
Длинный контекст, один из главных предметов гонки среди разработчиков языковых моделей, а работа утверждает, что он нужен меньше, чем принято считать. Если частое сжатие действительно сохраняет точность, то дорогие поздние токены можно заменить короткими контекстами. По данным аннотации, разница в стоимости генерации поздних и ранних токенов на открытых передовых моделях может доходить до 7 раз. Это экономический аргумент в пользу авторского подхода, хотя вывод пока сформулирован осторожно: «ставит под вопрос», а не «опровергает».
Кому это важно
Разработчикам приложений и агентов на основе языковых моделей, которые платят за длинные контексты и ищут способы снизить затраты. Исследователям архитектур, интересующимся альтернативами длинному контексту, включая идею семантических моделей пространства состояний. Командам, которые запускают долгие задачи по разработке ПО и упираются в рост стоимости с длиной контекста.
Как это применить
Из аннотации нельзя вывести готовый рецепт: способ сжатия контекста и устройство SSSMs в ней не описаны. Практический ориентир один: стоит проверить на собственных долгих задачах, насколько падает точность, если регулярно сжимать контекст вместо накопления всей истории. Сравнивать нужно на своих данных, а не полагаться на общее утверждение авторов.
Можно ли доверять
Доступен только текст аннотации препринта. В нём нет названий моделей и тестовых наборов, нет числовых показателей точности («мало или нет потерь» не измерено в цифрах), и нельзя оценить, насколько убедительны эксперименты. Утверждения принадлежат авторам работы и самостоятельно не проверены. Формулировка вывода («ставят под вопрос») умеренная, и читать её стоит именно так.
Риски и подводные камни
Семикратная разница в стоимости, максимум («до»), а не типичное значение, и указана только для передовых моделей с открытыми весами. Результат «мало или нет потерь» заявлен для широкого круга задач, но какие именно задачи вошли в выборку, неизвестно, поэтому переносить его на любой сценарий опасно. Эксперимент с одним действием на контекст показывает, что качество «не обрушивается», но не то, что оно равно качеству при полном контексте. Без полной статьи нельзя судить о затратах на само сжатие.
«Наши результаты ставят под вопрос необходимость языковых моделей с длинным контекстом.»
— из аннотации работы «You don't need long context»