Google Research представила Agile Deliberation: ИИ помогает уточнять «серые зоны» в классификаторах изображений
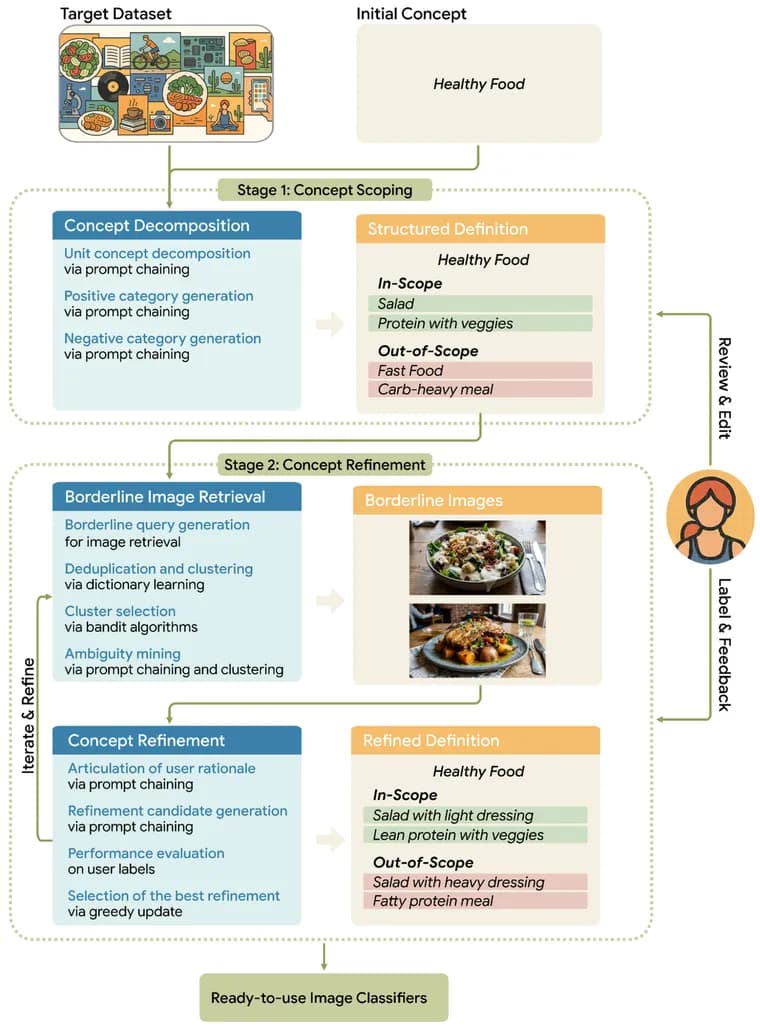
Исследователи Google Research Отилия Стрецу (Otilia Stretcu) и Лейцзе Ван (Leijie Wang) опубликовали 4 ноября 2026 года пост об Agile Deliberation, подходе к построению классификаторов изображений для субъективных категорий вроде «здоровой еды», «вдохновляющего искусства» или задач модерации контента. Проблема в том, что обычное обучение предполагает: человек, размечающий данные, заранее чётко и устойчиво понимает категорию. Для «стоп-знака» или «золотистого ретривера» это верно, но у субъективных понятий границы зависят от культурного контекста, личных взглядов или меняющихся правил, а полной спецификации люди обычно не имеют даже в голове: сначала есть интуитивная идея, а границы и исключения проясняются при встрече с реальными примерами.
Agile Deliberation превращает создание такого классификатора в итеративный диалог: ИИ выступает не просто получателем меток, а партнёром, который помогает пользователю «обдумать» и уточнить собственное определение. Процесс состоит из двух этапов. На первом, определении рамок понятия (concept scoping), система помогает разбить широкое понятие на иерархию подкатегорий и явных исключений. Пример из поста: «здоровую еду» можно разложить на «салаты», «боулы с крупами» и «постное мясо», а исключениями сделать «обработанные продукты» и «сырые неприготовленные ингредиенты».
На втором этапе, итерации понятия (concept iteration), идея заимствована у активного обучения, но с отличием: вместо выбора примеров, которые лишь снижают неуверенность модели, система с помощью моделей «зрение, язык» (VLM) ищет и показывает семантически пограничные изображения, ставящие под сомнение текущие текстовые определения. Например, фруктовый смузи заставляет решить: это полезный напиток из сырых фруктов или исключённая обработанная еда из-за большого количества сахара? Размышляя над такими случаями, пользователь осознаёт скрытые допущения и правит правила, а его обратная связь напрямую попадает в цикл автоматической оптимизации промпта, так что границы классификации VLM сдвигаются вместе с уточнённым определением.
Оценивать такие системы сложно: объективной эталонной разметки нет, а оффлайн-тесты на заранее размеченных наборах не показывают, как система подстраивается под меняющееся представление человека о понятии. Поэтому авторы собрали работающий прототип и провели живое исследование: 18 сессий по 1,5 часа, где участники работали с системой и альтернативными подходами в случайном порядке, чтобы исключить эффект обучения. Для проверки выбрали две сложные субъективные предметные области и сравнивали Agile Deliberation с тремя распространёнными подходами; в тексте поста они не названы.
По словам авторов, участники, прошедшие структурированное обдумывание, показали значительно более высокую согласованность разметки со временем и построили классификаторы, существенно превзошедшие все стандартные базовые подходы. Наибольший выигрыш пришёлся на самые трудные субъективные изображения, там, где обычные классификаторы ошибаются, опираясь на типовые допущения ИИ вместо явных намерений пользователя. Эксперты назвали систему эффективным диагностическим инструментом: пограничные картинки помогли найти «слепые пятна» в исходных определениях.
Ручная работа с промптами оказалась тяжёлой: пользователи испытывали выраженную когнитивную усталость, пытаясь угадать поисковые запросы для поиска пограничных случаев, и постоянно тревожились, что правка текста промпта ради одной ошибки испортит уже исправленное. В Agile Deliberation пользователю не нужно быть промпт-инженером: он смотрит подобранную галерею пограничных изображений и даёт обратную связь, а система сама обновляет модель. Участники сообщили, что чувствовали себя заметно менее напряжёнными, раздражёнными и вымотанными, и каждый предпочёл Agile Deliberation ручным методам.
Авторы открыли код и алгоритмы на GitHub и приложили интерактивную демонстрацию в Colab/Jupyter на примере «здоровой еды». Среди возможных применений названы фильтры модерации для команд доверия и безопасности, помощь кураторам цифровых коллекций и категоризация сложных визуальных данных учёными. Работа выполнена в партнёрстве Google Research и Google Ads.
Ключевые факты
- Agile Deliberation, подход Google Research, где ИИ ведёт пользователя через два этапа: определение рамок понятия (подкатегории и исключения) и итерацию на пограничных изображениях.
- Модели «зрение, язык» ищут спорные картинки (например, фруктовый смузи для «здоровой еды»), а ответы пользователя идут прямо в цикл автоматической оптимизации промпта.
- Проверка, живое исследование: 18 сессий по 1,5 часа, сравнение с тремя распространёнными подходами в случайном порядке; числовых метрик в посте нет.
- По словам авторов, согласованность разметки выросла, классификаторы превзошли все базовые подходы (сильнее всего, на самых трудных изображениях), а усталость и тревога снизились; каждый участник предпочёл новый подход ручным.
- Код и алгоритмы открыты на GitHub, есть демонстрация в Colab/Jupyter.
Почему это важно
Многие практические задачи, модерация контента, подбор «вдохновляющих» изображений, отбор «здоровой» еды, упираются в субъективные категории, которые человек не может описать полностью заранее. Авторы предлагают не требовать готовых жёстких меток, а помогать уточнять определение по ходу работы: ИИ показывает пограничные случаи, и пользователь на них осознаёт свои скрытые допущения. Это сдвиг от схемы, где ИИ лишь учится на человеческих метках, к двустороннему сотрудничеству.
Кому это важно
Прежде всего командам доверия и безопасности, которые строят фильтры модерации, кураторам цифровых коллекций и учёным, классифицирующим сложные визуальные данные, именно такие применения называют авторы. Также исследователям человеко-машинного обучения (human-in-the-loop) и всем, кто строит классификаторы на основе моделей «зрение, язык» и сталкивается с трудоёмкой ручной настройкой промптов.
Как это применить
Код и алгоритмы открыты на GitHub, а интерактивная демонстрация в Colab/Jupyter разбирает пример «здоровой еды». Авторы предлагают адаптировать её под свою область, где вы эксперт (например, выявление вводящих в заблуждение кликбейт-заголовков), или построить персональный классификатор под собственный вкус (например, «вдохновляющее искусство»). О ценах и лицензии в посте ничего не сказано.
Можно ли доверять
Источник, официальный блог Google Research, авторы, исследователи самой команды, так что все оценки результатов исходят от создателей метода. Результаты описаны словами «значительно» и «существенно»: ни точности, ни F1, ни процентов улучшения, ни статистических тестов в посте нет. Не названы две предметные области, три базовых подхода и использованная модель. Указано 18 сессий, но число участников не раскрыто. Полные данные, судя по тексту, изложены в сопутствующей статье, которую нужно читать отдельно.
Риски и подводные камни
Сильные утверждения (все базовые подходы побиты, каждый участник предпочёл новый метод) опираются на небольшое живое исследование из 18 сессий, и без числовых результатов масштаб выигрыша оценить нельзя. Пример со «здоровой едой» и смузи, иллюстрация, а не результат исследования. Подход по построению зависит от качества пограничных примеров, которые подбирает VLM, и от готовности пользователя участвовать в итерациях. В посте не сказано, что Google планирует выпускать это в продукте: упомянуто лишь партнёрство Google Research и Google Ads.