DreamX: видеодиффузионную модель превратили в обучатель латентных действий
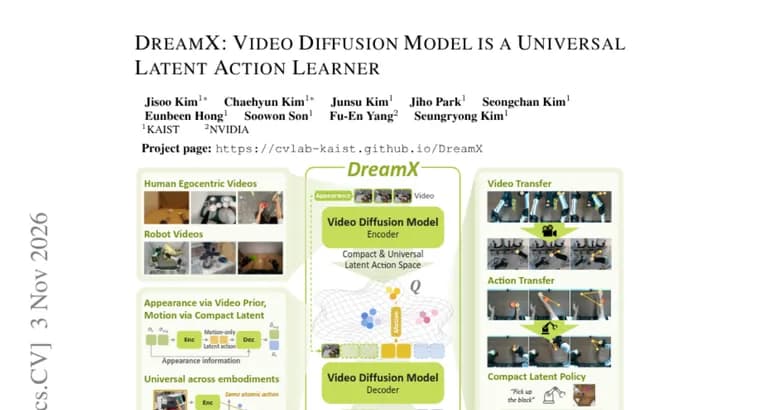
В препринте представлен DreamX, подход, который переиспользует предобученную видеодиффузионную модель как универсальный «обучатель» латентных действий. Задача, которую решают авторы: научиться представлению действия по видео так, чтобы оно было устойчивым для разных исполнений одного и того же действия и при этом не зависело от смены воплощения (человек или робот) и внешнего вида сцены.
По утверждению авторов, существующие модели латентных действий выводят действие из визуальных переходов между кадрами, но их представления часто смешивают само действие с посторонними визуальными вариациями. Из-за этого перенос между разными воплощениями получается ограниченным.
DreamX извлекает компактные латентные действия из богатых пространственно-временных признаков видеомодели. Каждый латентный кадр видео сжимается в 300 раз: с 1200 токенов до 4. Кроме того, опираясь на генеративный prior (априорные знания) видеомодели, эти латентные действия, как заявляют авторы, отражают динамику, значимую для действия, и отделены от внешнего вида. Получившееся латентное пространство служит общим интерфейсом действий для разных воплощений (человек и робот), сред и способов параметризации действий.
На бенчмарке LARY-Bench DreamX, по заявлению авторов, показывает лучший результат среди моделей латентных действий. Действия, закодированные в одной обстановке, остаются рабочими в другой: латентное пространство поддерживает перенос видео «любое-в-любое» (any-to-any) и перенос действий без дообучения (zero-shot) между разными воплощениями и средами. Наконец, общий интерфейс позволяет обучать политики управления прямо в компактном пространстве латентных действий, что снижает вычислительную стоимость политик на основе видеодиффузии.
Ключевые факты
- DreamX переиспользует предобученную видеодиффузионную модель как универсальный обучатель латентных действий.
- Каждый латентный кадр видео сжимается в 300 раз: с 1200 до 4 токенов.
- Латентное пространство служит общим интерфейсом действий для людей и роботов, разных сред и параметризаций действий.
- На LARY-Bench DreamX, по заявлению авторов, лучший среди моделей латентных действий; поддерживается перенос видео any-to-any и zero-shot перенос действий.
- Обучение политик в компактном латентном пространстве снижает вычислительную стоимость политик на основе видеодиффузии.
Почему это важно
Перенос навыков между людьми и разными роботами упирается в то, что представления действий привязаны к внешнему виду и конкретному воплощению. DreamX пытается отделить действие от визуальных вариаций, используя генеративный prior видеомодели, и получить единый интерфейс действий. Заявленное сжатие кадра с 1200 до 4 токенов к тому же делает такое представление компактным.
Кому это важно
Исследователям робототехники и обучения по видео, работающим с моделями латентных действий и политиками на основе видеодиффузии. Интересно тем, кто хочет переиспользовать человеческие видео для обучения роботов, поскольку авторы заявляют общий интерфейс для людей и роботов.
Как это применить
Сейчас это препринт, и в изложении источника нет упоминания о выпуске кода или моделей. Практически его можно использовать как ориентир идеи: брать признаки предобученной видеомодели, сжимать их в короткие латентные действия и обучать политики в этом компактном пространстве, чтобы снизить вычислительные затраты.
Можно ли доверять
Все утверждения, самооценка авторов из аннотации. В источнике не названы авторы и организации, не приведены числовые результаты на LARY-Bench (лишь «лучший среди моделей латентных действий»), не указаны название и размер использованной видеомодели, а выигрыш в вычислительной стоимости не измерен. Независимой проверки нет.
Риски и подводные камни
Заявление о лидерстве ограничено моделями латентных действий на одном бенчмарке. В аннотации нет данных об экспериментах на реальных роботах, показателей успеха и деталей обучения, поэтому практическую применимость переноса без дообучения нужно проверять по полному тексту статьи. Масштаб экономии вычислений не количественно подтверждён.