Спекулятивное декодирование для ИИ-агентов: черновую модель учат «проваливаться»
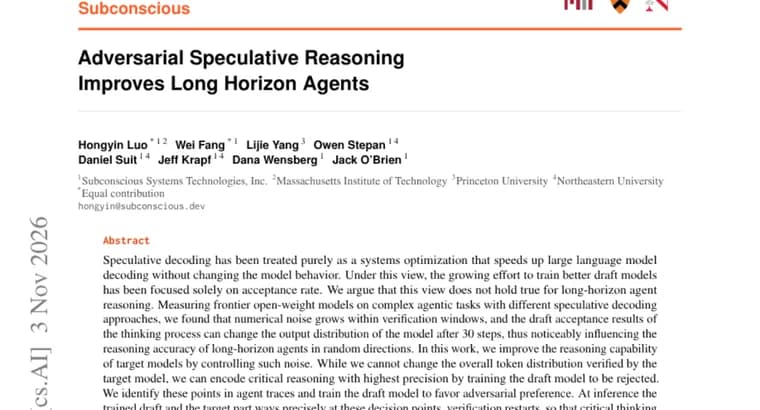
Спекулятивное декодирование (speculative decoding) принято считать чисто системной оптимизацией: небольшая черновая модель предлагает токены, а большая целевая их проверяет, и за счёт этого генерация ускоряется, а поведение модели не меняется. Из этого следует, что усилия по обучению более удачных черновых моделей сводились к одному, повысить долю принятых токенов (acceptance rate). Авторы препринта с Hugging Face утверждают, что для рассуждений ИИ-агентов с длинным горизонтом такой взгляд неверен.
Измеряя frontier open-weight модели (передовые модели с открытыми весами; какие именно, в тексте не указано) на сложных агентных задачах с разными схемами спекулятивного декодирования, авторы обнаружили, что численный шум нарастает внутри окон верификации. Результаты принятия черновика в ходе рассуждения могут изменить выходное распределение модели после 30 шагов и заметно влиять на точность рассуждений агентов в случайных направлениях.
Предложенное решение, управлять этим шумом. Общее распределение токенов, которое проверяет целевая модель, изменить нельзя. Но можно закодировать критически важные рассуждения с наибольшей точностью, если обучить черновую модель так, чтобы её отвергали. Авторы находят такие критические точки в трассах работы агентов и обучают черновую модель отдавать предпочтение «состязательному» варианту (adversarial preference).
Во время вывода обученный черновик и целевая модель расходятся именно в этих точках принятия решений, проверка запускается заново, и ключевые токены рассуждения выбираются из целевой модели и кодируются в наименее шумных для неё условиях. По словам авторов, так важные рассуждения лучше индексируются и дольше сохраняются на длинной дистанции.
На сложных агентных бенчмарках по программированию подход, как утверждают авторы, повышает итоговую долю успешных выполнений (end-to-end success rate) без изменения целевой модели и её выходного распределения. Обучается 0,06-0,28% размещаемых (hosted) параметров. Авторы предлагают переосмыслить спекулятивное декодирование: не просто ускоритель, а активный механизм распределения точности контекста.
Ключевые факты
- Авторы оспаривают представление о спекулятивном декодировании как о чисто системной оптимизации: для агентов с длинным горизонтом оно влияет на точность рассуждений.
- По их измерениям на передовых моделях с открытыми весами, численный шум растёт внутри окон верификации, а результаты принятия черновика могут изменить распределение выхода модели после 30 шагов.
- Метод: найти критические точки в трассах агентов и обучить черновую модель так, чтобы в этих точках её отвергали, а ключевые токены брала целевая модель в наименее шумных условиях.
- На сложных агентных бенчмарках по программированию заявлен рост итоговой доли успешных выполнений без изменения целевой модели; обучается 0,06-0,28% размещаемых параметров.
Почему это важно
Спекулятивное декодирование широко используется для ускорения работы больших языковых моделей, и считается, что оно не меняет поведение модели. Работа предлагает взглянуть иначе: на длинных цепочках действий агента накапливается численный шум, и принятие черновика может случайным образом ухудшать точность рассуждений. Если это подтвердится, обучение черновых моделей придётся оценивать не только по доле принятых токенов, но и по влиянию на результат агента.
Кому это важно
Тем, кто строит и запускает ИИ-агентов с длинными цепочками шагов, особенно для программирования, и тем, кто разрабатывает или обучает черновые модели для ускоренного вывода (инференса). Для широкой аудитории тема нишевая.
Как это применить
Напрямую применить пока нечего: в источнике, а это страница препринта с аннотацией, не названы код, релиз или условия доступа. Ориентир для практиков, идея обучать небольшую часть параметров черновой модели (0,06-0,28% размещаемых параметров, по заявлению авторов) на трассах агента, чтобы она расходилась с целевой моделью в критических точках.
Можно ли доверять
Это препринт, а материал на странице, только аннотация. В ней не названы авторы и организации, не указаны конкретные бенчмарки, протестированные модели и величина прироста успешности, нет данных об ускорении или задержках. Все утверждения принадлежат авторам, независимого подтверждения в источнике нет.
Риски и подводные камни
Эффект заявлен без количественных цифр, поэтому судить о его величине нельзя. Неясно, как метод скажется на скорости, ради которой спекулятивное декодирование и применяют: в аннотации данных об этом нет. Утверждение о шуме и 30 шагах основано на измерениях авторов на нескольких не названных моделях и может не переноситься на другие модели и схемы декодирования.