On-policy distillation учит языковую модель рассуждать, но не добавляет знаний
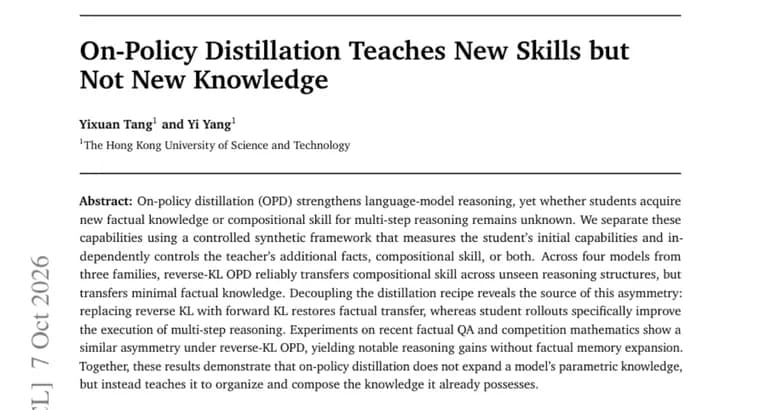
Дистилляция on-policy (on-policy distillation, OPD) усиливает рассуждения языковых моделей, но до сих пор было неизвестно, что именно получает модель-ученик: новые фактические знания или композиционный навык многошаговых рассуждений. Авторы работы разделили эти две способности с помощью контролируемой синтетической постановки. Она измеряет исходные способности ученика и независимо задаёт, что именно добавляет учитель: дополнительные факты, композиционный навык или и то и другое.
На четырёх моделях из трёх семейств OPD с reverse KL надёжно переносит композиционный навык на ранее не встречавшиеся структуры рассуждений, но почти не переносит фактические знания. Чтобы найти источник этой асимметрии, авторы разобрали рецепт дистилляции на составляющие. Замена reverse KL на forward KL восстанавливает перенос фактов, а прогоны самого ученика (student rollouts) улучшают именно выполнение многошаговых рассуждений.
Эксперименты на современных задачах фактического вопросно-ответного типа и на олимпиадной математике показали похожую асимметрию при reverse-KL OPD: заметный рост качества рассуждений без расширения фактической памяти. Вывод авторов: on-policy distillation не расширяет параметрические знания модели, а учит её организовывать и компоновать те знания, которые у неё уже есть.
Ключевые факты
- Вопрос, который авторы считают открытым: получает ли ученик при OPD новые факты или навык многошаговых рассуждений.
- Синтетическая постановка отделяет факты от навыка: измеряет исходные способности ученика и независимо задаёт, что добавляет учитель.
- На четырёх моделях из трёх семейств reverse-KL OPD надёжно переносит композиционный навык на новые структуры рассуждений, а фактические знания переносит минимально.
- Замена reverse KL на forward KL восстанавливает перенос фактов; прогоны ученика улучшают именно выполнение многошаговых рассуждений.
- Похожая асимметрия наблюдается на фактическом вопросно-ответном наборе и олимпиадной математике: рассуждения растут, фактическая память не расширяется.
Почему это важно
OPD применяют, чтобы усилить рассуждения моделей, но природа выигрыша оставалась невыясненной: новые знания или лучшая «сборка» уже имеющихся. Работа даёт конкретный ответ в рамках протестированных постановок: прирост связан с умением организовывать и компоновать знания, а не с их расширением. Кроме того, асимметрия прослежена до конкретного компонента рецепта: за перенос фактов отвечает выбор между reverse KL и forward KL.
Кому это важно
Исследователям и инженерам, которые занимаются пост-обучением и дистилляцией языковых моделей и выбирают, чем именно «кормить» ученика и какой функцией потерь его учить. Также тем, кто оценивает, чего можно ждать от дистилляции: усиления рассуждений или пополнения базы фактов.
Как это применить
По результатам авторов, если цель дистилляции в улучшении многошаговых рассуждений, подходит OPD с reverse KL. Если нужен перенос фактических знаний, замена reverse KL на forward KL, по их данным, восстанавливает такой перенос. В аннотации не упомянуты публикация кода, данных или моделей, так что воспроизводить результаты придётся по описанию постановки.
Можно ли доверять
Это только аннотация статьи на Hugging Face Papers: в ней не названы авторы и организации, не указаны сами четыре модели и три семейства, нет численных результатов и названий конкретных наборов задач. Поэтому проверить размер эффектов по тексту нельзя. Утверждения сформулированы самими авторами и опираются на контролируемую синтетическую постановку плюс эксперименты на фактическом вопросно-ответном наборе и олимпиадной математике.
Риски и подводные камни
Вывод сформулирован для протестированных постановок: синтетической среды, четырёх моделей и двух дополнительных типов задач. Из аннотации не следует, что он верен для всех рецептов OPD или для моделей другого масштаба. Синтетическое разделение «факты против навыка» удобно для измерений, но реальные задачи смешивают обе составляющие. Формулировку «OPD не расширяет знания» стоит читать как результат при reverse KL: с forward KL, по тексту работы, перенос фактов возвращается.
«Вместе эти результаты показывают, что on-policy distillation не расширяет параметрические знания модели, а учит её организовывать и компоновать знания, которыми она уже обладает.»
— из аннотации статьи на Hugging Face Papers