VocabX: словарь токенов под задачу снизил стоимость проверки эссе на 77%
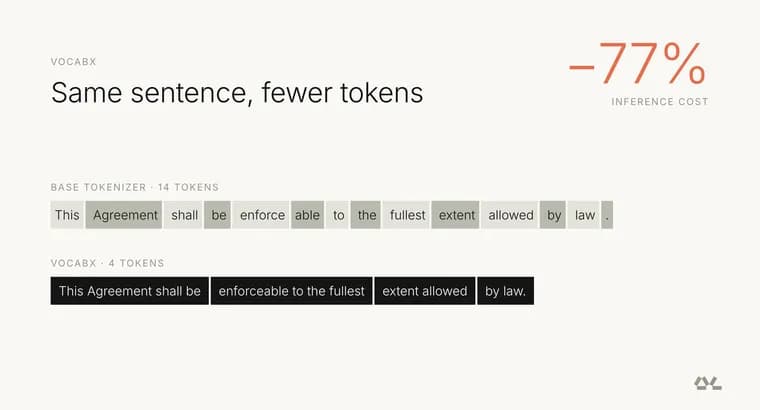
Авторы блога на Hugging Face рассказали о предварительных результатах метода VocabX, описанного в ещё не опубликованной статье (она на рецензии, и цифры до публикации могут измениться). Идея в том, чтобы не оставлять токенизатор базовой модели «как есть», а перестроить словарь токенов под одну предметную область, выбирая токены не по частоте, а по стоимости.
Исходная задача, рабочая система, которую авторы запускают в продакшене: автоматический проверяющий португальских эссе на базе Qwen3-4B (4 млрд параметров). Он получает эссе, тему и вспомогательные тексты и возвращает JSON-оценку с баллом и комментарием по каждой компетенции. Модель уже была небольшой и дообученной, но токенизатор остался исходным от Qwen3-4B, рассчитанным на много языков и типов текста. Это давало две потери: текст, который проверяющий пишет в каждом ответе, занимал больше токенов, чем нужно, а на каждом сгенерированном токене модель оценивала словарь из 151 669 записей, многие из которых в этой задаче почти не нужны.
Авторы называют две проблемы общего словаря. Первая, дробление: то, что в области повторяется чаще всего (у проверяющего это одинаковая JSON-обёртка, названия компетенций, оценочные фразы), режется на много токенов вместо одного. Вторая, избыточность: десятки тысяч записей не используются, но модель считает оценки для всех на каждом шаге генерации.
Почему важна именно стоимость, а не число токенов. Инференс делится на две фазы. В prefill (обработка входа) модель проходит весь вход за один проход, и упор идёт в вычисления. В decode (генерация) ответ создаётся по одному токену, на каждый нужен полный проход, и упор идёт в пропускную способность памяти. Поэтому сгенерированный токен дороже прочитанного: в измеренном случае проверяющего, в 7,4 раза, хотя соотношение зависит от оборудования, задачи, размера пакета, длины контекста и может быть больше. Направление, по словам авторов, сохраняется в целом: генерация дороже чтения. Третья составляющая счёта, сам словарь: выходной слой (LM head) хранит строку параметров на каждую запись, и в модели размера Qwen3-4B эта матрица занимает почти 10% параметров; при генерации она читается целиком на каждом токене. В проверяющем выходной слой сократился примерно с 152 000 до примерно 65 000 строк. Сам размер этой матрицы VocabX в критерий выбора напрямую не включает, но ограничивает его двумя способами: заменой базового словаря на меньший доменный на уровне подслов и фиксированным бюджетом макротокенов.
Существующие методы, fast vocabulary transfer (FVT), multi-word tokenization (MWT) и in-place BPE от Liquid AI, по оценке авторов, выбирают токены по частоте, а не по стоимости, и работают лишь на одном уровне: либо меняют разрезание слов на части, либо склеивают целые фразы в один токен.
VocabX отличается тремя вещами. Во-первых, он спрашивает не «сколько токенов экономит кандидат», а «сколько стоимости и времени он экономит»: каждый устранённый токен умножается на цену поля, где он встречается (системный промпт, сообщение пользователя или ответ модели). В случае проверяющего токен, сэкономленный в ответе, считается в 7,4 раза ценнее сэкономленного во входе. Во-вторых, метод работает сразу на двух уровнях с общим критерием стоимости и отдельным бюджетом на каждый: перестраивает разрезание доменных слов на подслова и находит повторяющиеся отрезки (от коротких выражений до целых строк и JSON-обёрток), превращая каждый в один макротокен. Для поиска таких отрезков служат пять майнеров, автоматических поисков повторов: длинные слова, целые строки, выражения, полные предложения и структуры с пунктуацией (JSON, теги). В среднем по восьми корпусам больше всего дал последний, на коде в одиночку, 17,5 пункта; без всех пяти сокращение числа токенов у проверяющего упало бы на 55,6 пункта. В-третьих, метод оценивает то, чего не видит выборка. Точный расчёт выигрыша кандидата после уже выбранных потребовал бы пересчитывать весь корпус десятки тысяч раз, поэтому его считают на выборке документов, и отсутствующий в ней кандидат получает нулевой выигрыш. Но выражение, встречающееся 37 раз в 50 000 документов, попадает в выборку из 400 документов лишь примерно в 26% случаев, а в корпусе контрактов в такую выборку попадают только 16,6% кандидатов. Авторы считают точно ту часть выигрыша, что не требует выборки, а для невидимых кандидатов подставляют статистическую оценку по поведению видимых вместо нуля. Одно это изменение при той же выборке и том же бюджете подняло сокращение числа токенов на корпусе контрактов с 44,7% до 52,8%.
Измерения на проверяющем. Авторы обучили семь версий проверяющего с одной и той же базовой моделью, данными, рецептом обучения и зерном случайности: отличался только токенизатор. Все версии прогнали одни и те же 500 запросов на одной машине с GPU RTX 5090 и сервером инференса vLLM, стоимость считали по измеренному времени работы. Средняя длина ответа упала с 350 до 101 токена, стоимость снизилась на 77,0%, а оценка на тестовом наборе (bench score, объединяющая точность выставления оценок и точность отсева эссе не по теме или с нарушением правил) выросла с 0,703 до 0,810.
К этому пришли не сразу. Первая версия словаря склеивала оценку каждой компетенции с окружающим JSON в один макротокен: она была самой компактной, но качество упало, 0,689 против 0,703 у продакшен-версии, потому что каждая комбинация оценки и структуры стала отдельным вариантом токена, и модель выбирала оба сразу за один шаг. Когда оценке выделили собственный токен, это стоило 2 лишних токена на ответ, зато оценка выросла до 0,810 и в измерении выигрыш по стоимости оказался даже больше: 77,0% против 73,3% у склеенной версии. Вывод авторов: сжатие имеет цену, когда сжимаемый отрезок несёт само решение, ради которого существует модель.
Проверка за пределами проверяющего. Чтобы понять, не специфичен ли выигрыш для их случая, VocabX сравнили с тремя эталонными методами на пяти открытых областях (договоры, медицинские статьи, научные статьи, новости и код на Python) и трёх семействах моделей (Qwen3, Llama-3.1 и Gemma-3), с одними и теми же документами для поиска и теста и одним потолком размера словаря. По степени сжатия VocabX обошёл сильнейший эталонный метод во всех пятнадцати комбинациях, на 1,2-9,3 пункта. По оценочной стоимости инференса урезанная версия VocabX тоже лидировала во всех пятнадцати, в среднем на 10,2 пункта на Qwen3, 7,5 на Llama-3.1 и 13,6 на Gemma-3. На договорах урезанная версия достигла сокращения токенов на 62,6% при 113 426 записях словаря против 61,8% у лучшей конфигурации in-place BPE.
Ключевые факты
- VocabX строит словарь токенов под одну область по стоимости, а не по частоте: токен в ответе модели считается дороже токена на входе (в случае проверяющего, в 7,4 раза).
- На проверяющем португальские эссе на Qwen3-4B (RTX 5090, vLLM, 500 запросов) измеренная стоимость упала на 77,0%, средний ответ сократился с 350 до 101 токена, а оценка на тесте выросла с 0,703 до 0,810.
- Первая версия, склеивавшая оценку с JSON в один макротокен, дала 73,3% экономии, но просадила качество до 0,689; отдельный токен для оценки вернул качество и улучшил экономию до 77,0%.
- На пяти открытых областях и трёх семействах моделей (Qwen3, Llama-3.1, Gemma-3) VocabX сжал сильнее лучшего эталонного метода во всех 15 комбинациях, на 1,2-9,3 пункта.
- Цифры взяты из текущей версии статьи, которая ещё на рецензии, и могут измениться до публикации.
Почему это важно
Токенизатор обычно считают неизменной частью базовой модели, а здесь он назван одним из крупнейших рычагов стоимости для модели, заточенной под одну область, причём он задаётся ещё до обучения. Идея о том, что считать нужно не токены, а их цену (генерация дороже чтения, а крупный словарь утяжеляет каждый шаг генерации), объясняет, почему простое сокращение числа токенов не гарантирует экономии. Авторы заявляют 77% снижения стоимости без смены базовой модели и с ростом оценки на тесте.
Кому это важно
Командам, которые дообучают небольшие открытые модели вроде Qwen или Gemma под узкую задачу с повторяющимся форматом ответа (структурированный JSON, шаблонные формулировки, договоры, код) и сами оплачивают инференс. Также исследователям токенизации и адаптации словарей, для которых показательно сравнение с FVT, MWT и in-place BPE.
Как это применить
Готового инструмента в изложенном тексте не описано: метод пока представлен предварительно, а статья ещё не опубликована. Практический вывод для своих систем, смотреть на токенизатор как на настраиваемую часть: оценить, какие повторяющиеся отрезки ответа дробятся на много токенов, взвесить токены по цене поля (вход против выхода) и не склеивать в один токен фрагменты, несущие само решение модели, как это сделали с оценкой в первой версии проверяющего.
Можно ли доверять
Это предварительный обзор из блога авторов метода, а не рецензированная публикация: они сами оговаривают, что статья на рецензии и цифры могут измениться. Главные 77% получены на одном проверяющем (португальские эссе, Qwen3-4B) на одной машине с RTX 5090 и vLLM по 500 запросам; для открытых тестов 77% не заявляется. Абсолютные цифры в деньгах, задержку и пропускную способность авторы не приводят, независимой проверки нет.
Риски и подводные камни
Выигрыш зависит от соотношения цены генерации и чтения (7,4 раза измерено лишь для этого проверяющего и меняется с оборудованием, размером пакета и длиной контекста). Чрезмерное сжатие может ударить по качеству: склеенный вариант с оценкой внутри макротокена дал 0,689 против 0,703 у исходной версии. Метод заточен под одну область и формат ответа, и для универсальной модели такой словарь по определению не годится. Не указано, что продакшен-проверяющий уже переведён на словарь VocabX, и не упомянуты код или веса.
«Цель, не самый дешёвый из возможных словарь, а самый дешёвый из тех, что сохраняют важные токены.»
— авторы блога на Hugging Face