Agent4Sci: ИИ-агенты улучшили лучшие научные ML-модели, но без научных идей
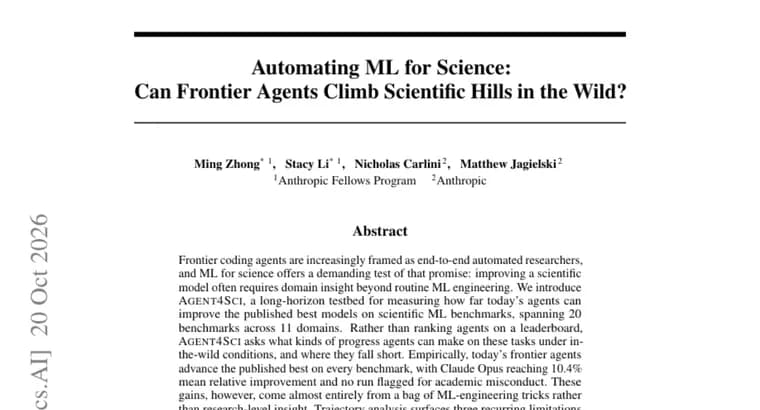
Авторы работы исходят из того, что передовые кодинг-агенты всё чаще подают как автоматических исследователей «под ключ». Машинное обучение для науки, трудная проверка этого обещания: чтобы улучшить научную модель, часто нужно понимание предметной области, выходящее за рамки обычной ML-инженерии.
Для проверки они представили Agent4Sci, долгосрочный испытательный стенд, который измеряет, насколько сегодняшние агенты способны улучшить лучшие опубликованные модели на научных ML-задачах. В набор входят 20 бенчмарков из 11 предметных областей. Цель, не составить рейтинг агентов, а понять, какой прогресс они могут сделать в условиях, близких к реальным («in the wild»), и где им не хватает возможностей.
Результат: передовые агенты улучшили лучший опубликованный результат на каждом бенчмарке. Claude Opus показал среднее относительное улучшение 10,4%, и ни один запуск не был помечен как нарушение академической этики (misconduct). Однако, по словам авторов, эти приросты почти целиком получены за счёт набора ML-инженерных приёмов, а не исследовательского понимания.
Анализ траекторий работы агентов выявил три повторяющихся ограничения: неверную оценку новизны (novelty miscalibration), недоиспользование доступных ресурсов и быстрое сползание к локальному инженерному перебору вариантов (sweeps).
Лёгкие подключаемые навыки (plug-in skills) для генерации исследовательских идей, управления экспериментами и плановых чек-листов подняли результат Claude Opus с 10,4% до 20,1%, а Codex, с 4,4% до 8,1%. При этом вмешательства агентов стали разнообразнее и ближе к предметной области. По замыслу авторов, Agent4Sci даёт сообществу способ отслеживать и подталкивать агентов от ML-инженерии к предметному пониманию на реальных задачах научного ML. Код и данные опубликованы на GitHub и Hugging Face.
Ключевые факты
- Agent4Sci, испытательный стенд из 20 бенчмарков в 11 областях науки, где агенты пытаются улучшить лучшие опубликованные модели.
- Передовые агенты превзошли лучший опубликованный результат на каждом бенчмарке; Claude Opus показал среднее относительное улучшение 10,4%, нарушений академической этики не отмечено.
- Приросты почти целиком дали ML-инженерные трюки, а не исследовательские идеи; найдены три ограничения: неверная оценка новизны, недоиспользование ресурсов, быстрый уход в локальный инженерный перебор вариантов.
- Подключаемые навыки для генерации идей, управления экспериментами и чек-листов подняли Claude Opus с 10,4% до 20,1%, Codex, с 4,4% до 8,1%.
- Код и данные открыты на GitHub и Hugging Face.
Почему это важно
Кодинг-агентов всё чаще представляют как автоматических исследователей. Agent4Sci проверяет это на задачах, где нужен предметный инсайт, и показывает неоднозначную картину: агенты действительно улучшают опубликованные рекорды на всех 20 бенчмарках, но выигрывают в основном за счёт инженерных приёмов, а не новых научных идей.
Кому это важно
Исследователям, которые применяют ИИ-агентов в научном машинном обучении, разработчикам самих агентов и тем, кто строит бенчмарки для оценки автоматизации науки. Стенд предназначен для того, чтобы сообщество отслеживало продвижение агентов от ML-инженерии к предметному пониманию.
Как это применить
Код и данные Agent4Sci опубликованы на GitHub (maszhongming/agent4sci) и в виде датасета на Hugging Face, их можно использовать для собственных замеров. Практический вывод из работы: лёгкие навыки для генерации идей, управления экспериментами и плановых чек-листов заметно повышают результат агентов, у Claude Opus с 10,4% до 20,1%, у Codex с 4,4% до 8,1%.
Можно ли доверять
Это аннотация работы, все выводы принадлежат её авторам; в тексте не названы авторы и организации, не указаны конкретные версии Claude Opus и Codex, число запусков, вычислительный бюджет и результаты по отдельным бенчмаркам. Не сказано, как проверялось отсутствие нарушений академической этики. Метрика для чисел 20,1%, 4,4% и 8,1% в аннотации отдельно не названа. Код и данные открыты, так что результаты можно перепроверить.
Риски и подводные камни
Из аннотации следует, что рост показателей не равен научному открытию: агенты склонны неверно оценивать новизну, не используют доступные ресурсы полностью и быстро скатываются в локальный перебор инженерных вариантов. Если смотреть только на цифру улучшения, можно принять инженерную оптимизацию за исследовательский прогресс. Кроме того, из аннотации известно лишь про Claude Opus и Codex, поэтому обобщать выводы на всех агентов нельзя.