Бенчмарк SpatialScout: Claude Opus 5.5 набрал лишь 41,71% в 3D-картировании
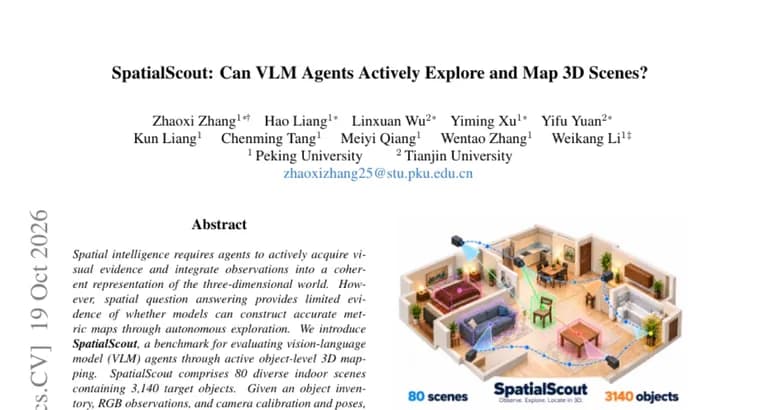
В статье представлен SpatialScout, бенчмарк для оценки агентов на основе vision-language моделей (VLM, моделей, понимающих изображения и текст) в задаче активного объектного 3D-картирования. Исходная мысль авторов: пространственный интеллект требует, чтобы агент сам добывал визуальные свидетельства и собирал наблюдения в цельное представление трёхмерного мира, а ответы на пространственные вопросы дают лишь ограниченное представление о том, умеют ли модели строить точные метрические карты в ходе самостоятельного исследования.
Бенчмарк включает 80 разных сцен в помещениях и 3 140 целевых объектов. Агенту дают список объектов, RGB-наблюдения, калибровку камеры и её позиции. Агент управляет камерой, исследует сцену и оценивает центры объектов в общей системе координат. Задача требует согласовать выбор точек обзора, сопоставление объектов между разными кадрами, геометрические оценки и пересмотр карты, причём при ограниченных бюджетах взаимодействия. Оценка одновременно измеряет точность локализации и полноту охвата целей через оценки перекрытия в масштабе объекта, которые штрафуют за пропущенные предсказания.
Эксперименты с передовыми VLM показали существенные ограничения. Сильнейшая из оценённых моделей, Claude Opus 5.5, получила среднюю оценку перекрытия 41,71%: у 47,23% целей пересечение с эталоном по метрике IoU (intersection-over-union, отношение площади пересечения к объединению) превысило порог 0,5, а порог 0,9 преодолели лишь 3,25%. По словам авторов, это показывает значительный разрыв между восстановлением грубой раскладки объектов и построением полной точной метрической карты. SpatialScout предлагается как количественный полигон для разработки агентов, надёжно строящих 3D-представления через активное восприятие. Код опубликован на GitHub (JesseZZZZZ/SpatialScout).
Ключевые факты
- SpatialScout, бенчмарк активного объектного 3D-картирования для VLM-агентов: 80 разных сцен в помещениях и 3 140 целевых объектов.
- Агент получает список объектов, RGB-кадры, калибровку и позиции камеры, сам управляет камерой и оценивает центры объектов в общей системе координат.
- Лучшая из оценённых моделей, Claude Opus 5.5, получила среднюю оценку перекрытия 41,71%.
- У Claude Opus 5.5 порог IoU 0,5 превысили 47,23% целей, а порог 0,9, только 3,25%.
- Авторы делают вывод о большом разрыве между грубой раскладкой объектов и полной точной метрической картой; код доступен на GitHub.
Почему это важно
Обычно пространственные способности моделей проверяют вопросами по изображениям. Авторы SpatialScout указывают, что такие вопросы мало говорят о том, умеет ли модель сама исследовать пространство и строить точную метрическую карту. Новый бенчмарк проверяет именно это. Результат лучшей из оценённых моделей, 41,71% средней оценки перекрытия и всего 3,25% целей выше порога IoU 0,9, показывает, по оценке авторов, значительный разрыв между грубым пониманием раскладки и точным картированием.
Кому это важно
Исследователям пространственного интеллекта и агентов с активным восприятием: бенчмарк задуман как количественный полигон для разработки таких систем. Также он интересен тем, кто оценивает возможности передовых VLM за пределами вопросов и ответов по изображениям.
Как это применить
Код бенчмарка опубликован на GitHub (JesseZZZZZ/SpatialScout), так что его можно использовать для оценки собственных VLM-агентов. Постановка задачи: на входе список объектов, RGB-наблюдения, калибровка и позиции камеры; на выходе, центры объектов в общей системе координат при ограниченном бюджете взаимодействия.
Можно ли доверять
Это описание работы в аннотации статьи на Hugging Face, все выводы принадлежат самим авторам бенчмарка. Названа только одна оценённая модель, Claude Opus 5.5; результатов других моделей нет, поэтому сравнить их по этому материалу нельзя. Авторы и организации в аннотации не указаны. Размер бюджета взаимодействия также не назван.
Риски и подводные камни
Число 41,71%, средняя оценка перекрытия на масштабе объекта со штрафом за пропуски; её не стоит путать с долей верно найденных объектов (47,23% при пороге IoU 0,5). Результаты относятся к конкретной постановке: 80 сцен в помещениях и ограниченный бюджет взаимодействия, поэтому переносить их на другие условия нужно осторожно. Бенчмарк оценивает только VLM-агентов в этой задаче.