SoL-Pi сократил расход токенов кодинг-агентов на 44,7, 49% без потери качества
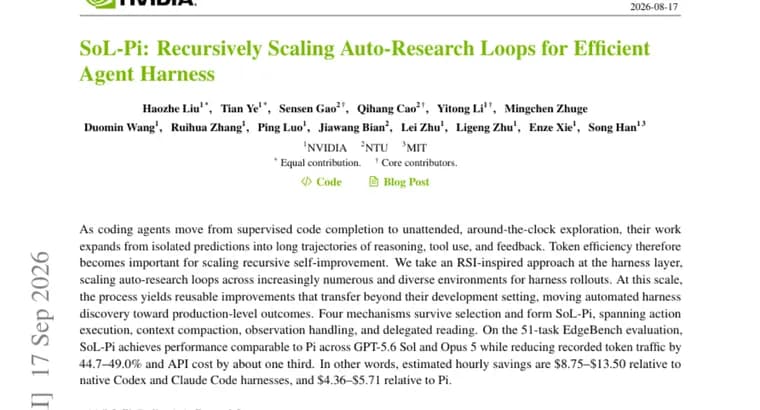
На HuggingFace Papers опубликована работа о SoL-Pi, надстройке над харнесом (программной обвязкой) кодинг-агентов, которая должна снижать расход токенов в долгих автономных сессиях без потери качества результата.
Отправная точка авторов: кодинг-агенты переходят от разовых подсказок под присмотром человека к круглосуточной автономной работе, и их задачи превращаются в длинные цепочки рассуждений, вызовов инструментов и обработки обратной связи. Это делает экономию токенов критичной для масштабирования подхода recursive self-improvement (рекурсивного самоулучшения, RSI), когда система сама итеративно совершенствует способ своей работы.
Авторы применили RSI-подход на уровне самого харнеса: они масштабировали циклы автоматического исследования (auto-research loops) на всё большее число разнообразных сред выполнения. По их описанию, на таком масштабе процесс даёт улучшения, которые переносятся за пределы среды, где их получили, то есть приближает автоматический поиск лучших харнес-решений к практически применимому результату.
Из этого поиска отобрали четыре механизма, которые вместе составили SoL-Pi: исполнение действий, сжатие контекста, обработка наблюдений и делегированное чтение.
На тестовом наборе из 51 задачи EdgeBench SoL-Pi показал качество, сопоставимое с существующей базовой системой под названием Pi (её устройство в тексте не раскрывается), при этом на моделях GPT-5.6 Sol и Opus 5 харнес снизил фактический трафик токенов на 44,7, 49,0% и сократил расходы на обращения к API примерно на треть. Авторы также приводят оценку почасовой экономии: $8,75, 13,50 по сравнению со штатными харнесами Codex и Claude Code и $4,36, 5,71 по сравнению непосредственно с Pi.
Ключевые факты
- SoL-Pi, харнес-надстройка для кодинг-агентов из четырёх механизмов: исполнение действий, сжатие контекста, обработка наблюдений, делегированное чтение.
- На бенчмарке из 51 задачи (EdgeBench) качество сопоставимо с базовой системой Pi, при этом трафик токенов сокращён на 44,7, 49,0%, а расходы на API, примерно на треть.
- Оценка экономии: $8,75, 13,50 в час против штатных харнессов Codex и Claude Code, $4,36, 5,71 в час против Pi.
- Тестирование проведено на моделях GPT-5.6 Sol и Opus 5; текст не уточняет, работает ли харнес поверх этих моделей или они использованы для сравнения.
- Метод описан как продолжение подхода RSI (рекурсивное самоулучшение), применённого на уровне харнеса, а не самой модели.
Почему это важно
Автономные кодинг-агенты работают долгими сессиями без присмотра человека, и это резко увеличивает объём токенов, которые харнес тратит на инструменты, контекст и обратную связь. SoL-Pi, попытка снизить эту стоимость на уровне самого харнеса, а не модели, сохранив при этом качество результата.
Кому это важно
Разработчикам агентных систем и командам, которые считают стоимость длинных автономных сессий (в частности, на базе харнессов вроде Codex или Claude Code): метод обещает почти двукратное сокращение токенов и экономию около трети по деньгам без заявленной потери качества.
Как это применить
Метод состоит из четырёх механизмов, исполнение действий, сжатие контекста, обработка наблюдений и делегированное чтение, и работает как надстройка над харнесом. По замыслу авторов это делает его переносимым между разными моделями без переобучения самой модели; в работе он проверен на GPT-5.6 Sol и Opus 5.
Можно ли доверять
Работа опубликована на HuggingFace Papers, имена авторов в тексте не указаны. Результаты получены на одном фиксированном бенчмарке (51 задача EdgeBench) и сравниваются с системой Pi, устройство которой в тексте не описано, независимой проверки данных пока нет.
Риски и подводные камни
Итоговые цифры экономии, относительные (проценты и доли к базовой системе Pi); абсолютная стоимость API в тексте не приводится, только оценка почасовой экономии в долларах. Происхождение и устройство сравнительной системы Pi не раскрыты, а из текста не ясно, участвуют ли GPT-5.6 Sol и Opus 5 как модели, на которых работает харнес, или как модели сравнения, это ограничивает независимую оценку результата.