RiskChainBench: новый бенчмарк проверяет ИИ на распознавании мошеннических ссылок
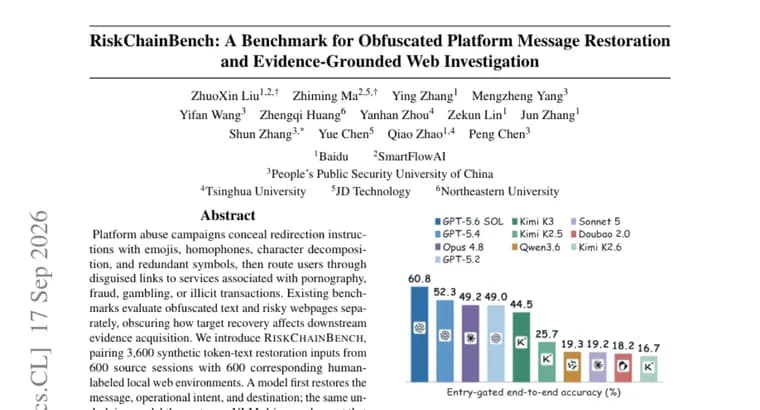
Кампании злоупотребления платформами маскируют инструкции о переходе на сторонние сайты, с помощью эмодзи, омофонов, разбиения символов на части и лишних знаков, и ведут пользователя по замаскированным ссылкам на ресурсы, связанные с порнографией, мошенничеством, азартными играми или нелегальными сделками. Существующие бенчмарки проверяли распознавание замаскированного текста и оценку опасных веб-страниц отдельно друг от друга, из-за чего было не видно, как ошибка на этапе восстановления цели сказывается на способности модели затем собрать доказательства уже на самом сайте.
Авторы представили RiskChainBench, бенчмарк, который связывает обе задачи в одну цепочку. Он состоит из 3600 синтетических заданий на восстановление замаскированного текста, собранных из 600 исходных сессий, и 600 парных к ним локальных веб-сред, размеченных людьми. Сначала модель восстанавливает исходное сообщение, скрытое операционное намерение и конечный адрес назначения (первая задача). Затем та же базовая модель выступает в роли веб-агента на основе VLM (модели, работающей с изображениями и текстом): она расследует именно тот сайт, адрес которого была определён на предыдущем шаге, и составляет «замороженный» отчёт о риске с опорой на цитируемые доказательства, без подсказок из смысла исходного сообщения и без сигналов о репутации домена (вторая задача).
Задачи оцениваются раздельно, а затем офлайн объединяются: правильность определения адреса из первой задачи используется как фильтр для результата второй, если модель ошиблась с адресом, расследование по определению не может быть засчитано верным. Корректность выполнения задач определяют разметчики-люди, а качество самого отчёта о риске, отдельный фиксированный мультимодальный «судья», который оценивает достоверность, достаточность, полноту и согласованность приведённых доказательств.
На десяти протестированных моделях точность восстановления адреса на первом шаге (Entry Top-1) колеблется от 35.2% до 95.2%, а точность итогового решения по сайту, от 26.3% до 62.8%. При этом лидер меняется в зависимости от подзадачи: модель, лучшая в восстановлении адреса, не обязательно лучшая в полной реконструкции сообщения, в решении по сайту или в точной классификации типа риска. Ключевой вывод авторов: 31.9% попыток веб-расследования срываются именно из-за сбоев в процессе выполнения, модель не может стабильно перемещаться по сайту и собирать доказательства, тогда как ошибки уже после того, как решение принято (неверная классификация типа риска), составляют лишь 0.9%. То есть узкое место, не итоговая классификация, а стабильность самого исследования и вынесения суждения.
Авторы публикуют в открытом доступе сам бенчмарк, протокол оценки и обнуляемую (сбрасываемую в исходное состояние) локальную песочницу для тестирования моделей.
Ключевые факты
- RiskChainBench объединяет 3600 заданий на восстановление замаскированных сообщений (из 600 исходных сессий) с 600 вручную размеченными локальными веб-средами.
- Модель сначала восстанавливает скрытое сообщение и адрес назначения, затем как VLM-агент самостоятельно расследует именно этот сайт и составляет отчёт о риске с опорой на доказательства.
- На десяти протестированных моделях точность восстановления адреса, от 35.2% до 95.2%, точность решения по сайту, от 26.3% до 62.8%; лидер меняется в зависимости от подзадачи.
- 31.9% попыток веб-расследования срываются из-за сбоев в самом процессе выполнения, и лишь 0.9%, из-за неверной итоговой классификации риска.
- Авторы выкладывают в открытый доступ сам бенчмарк, протокол оценки и обнуляемую локальную песочницу.
Почему это важно
Кампании злоупотребления платформами маскируют инструкции о переходе на другие сайты, эмодзи, омофонами, разбивкой символов на части, лишними знаками, и ведут пользователя по замаскированным ссылкам на порнографию, мошенничество, азартные игры или нелегальные сделки. До сих пор бенчмарки проверяли распознавание замаскированного текста и оценку опасных веб-страниц по отдельности, из-за чего было не видно, как ошибка на этапе восстановления цели сказывается на способности модели затем собрать доказательства на самом сайте. RiskChainBench впервые связывает эти две задачи в одну цепочку и оценивает их совместно.
Кому это важно
Бенчмарк адресован исследователям, которые разрабатывают и тестируют модели модерации контента и безопасности платформ, а также командам, создающим ИИ-агентов для автоматического расследования подозрительных ссылок. Значение он имеет и для площадок, которые сталкиваются с замаскированными редиректами на мошеннические, игорные или порнографические ресурсы.
Как это применить
Авторы публикуют сам бенчмарк (3600 заданий на восстановление сообщений и 600 парных веб-сред), протокол оценки и обнуляемую локальную песочницу, это позволяет любой команде прогнать собственную модель через обе задачи, восстановление сообщения и веб-расследование, и сравнить результат с десятью уже протестированными моделями. В источнике не указаны условия лицензирования, дата выпуска или площадка публикации.
Можно ли доверять
Источник, полный текст аннотации статьи на площадке Hugging Face Papers (14 голосов, 2 комментария на момент публикации). Корректность задач определяют разметчики-люди, а качество самих отчётов о риске, отдельный фиксированный мультимодальный судья, оценивающий достоверность, достаточность, полноту и согласованность доказательств. При этом в тексте не названы ни авторский коллектив, ни организации, ни конкретные названия десяти протестированных моделей, фигурируют только формулировки «десять моделей» и «та же базовая модель».
Риски и подводные камни
Главный вывод исследования, узкое место не в финальной классификации риска (там ошибка встречается лишь в 0.9% попыток), а в самом процессе исследования: 31.9% веб-расследований срываются из-за сбоев выполнения, когда модель не может стабильно перемещаться по сайту и собирать доказательства. Это значит, что даже модели с высокой точностью восстановления замаскированных сообщений (до 95.2%) на практике ненадёжны как автономные веб-агенты для расследования опасных ссылок. Веб-среды в бенчмарке синтетические и локальные, что упрощает разметку, но оставляет открытым вопрос переноса результатов на живые сайты в интернете.