Self-Retrospection Distillation учит ИИ-агентов предвидеть до действия
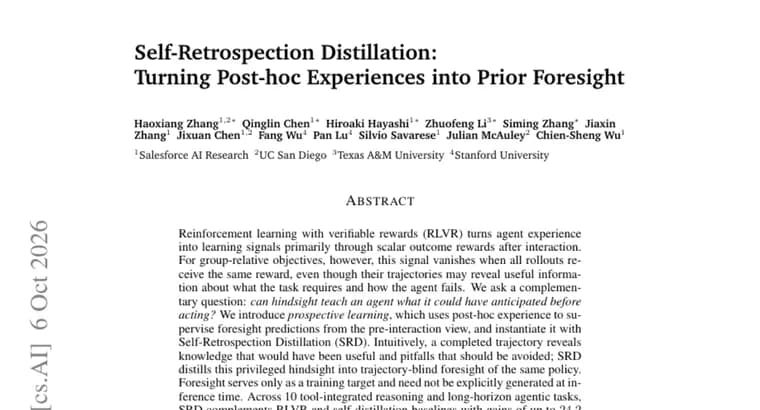
Обычное обучение с подкреплением и проверяемой наградой (RLVR) превращает опыт агента в обучающий сигнал в основном через скалярную награду за итог взаимодействия. Для групповых (group-relative) целевых функций у этого есть слабое место: если все попытки (прогоны, rollout) в группе получают одинаковую награду, сигнал обучения исчезает. При этом сами траектории могут многое рассказать о том, что требует задача и где агент ошибается.
Авторы статьи задают дополняющий вопрос: может ли ретроспектива научить агента тому, что он мог бы предвидеть до действия? Они вводят «проспективное обучение» (prospective learning): опыт, накопленный постфактум, используется как учитель для предсказаний-«предвидения», которые делаются с точки зрения момента до взаимодействия. Конкретная реализация называется Self-Retrospection Distillation (SRD, саморетроспективная дистилляция). Идея в том, что завершённая траектория раскрывает знания, которые были бы полезны, и ловушки, которых следовало избегать. SRD переносит эту «привилегированную ретроспективу» в «предвидение» той же самой модели, не видящее траектории. Предвидение нужно только как цель обучения и не обязано явно генерироваться на этапе вывода.
Результаты: на 10 задачах с рассуждением через инструменты и долгими агентными сценариями SRD дополняет базовые подходы RLVR и самодистилляции, давая прирост до 24,2 п.п. Преимущество особенно заметно, когда контраста наград мало: по данным авторов, на разных масштабах моделей от 37 до 98% групп прогонов имеют одинаковую награду, но SRD всё равно извлекает сигнал из выбранных траекторий. В конфигурации 2B, где 98% групп состоят только из неудач, обучение одним RLVR заканчивается на 0,0% успеха, а добавление SRD при том же бюджете прогонов доходит до 60,6%.
Вывод авторов, сформулированный осторожно: опыт агента постфактум полезен не только для оценки и улучшения поведения, но и для формирования предсказательных представлений до взаимодействия.
Ключевые факты
- Self-Retrospection Distillation (SRD) переносит знания из завершённой траектории в «предвидение» той же модели, не видящее эту траекторию; предвидение служит лишь целью обучения.
- Проблема, на которую нацелен метод: в групповых вариантах RLVR сигнал пропадает, если все прогоны группы получили одинаковую награду; по данным статьи, на разных масштабах моделей так выглядят 37, 98% групп.
- На 10 задачах с инструментами и долгими агентными сценариями SRD дополняет базовые подходы RLVR и самодистилляции с приростом до 24,2 п.п. (это верхняя граница).
- В конфигурации 2B, где 98% групп, сплошные неудачи, один RLVR даёт 0,0% успеха, а с SRD при том же бюджете прогонов, 60,6%.
- Все цифры приведены самими авторами в аннотации статьи.
Почему это важно
Обучение агентов с проверяемой наградой упирается в разреженность сигнала: когда все попытки в группе проваливаются (или все удаются), групповая целевая функция ничего не говорит модели. Статья предлагает брать сигнал не только из итоговой награды, но и из содержания самих траекторий. Самый яркий пример из аннотации, конфигурация 2B, где 98% групп состоят только из неудач: один RLVR остаётся на 0,0% успеха, а с SRD результат достигает 60,6% при том же бюджете прогонов.
Кому это важно
Исследователям и инженерам, которые дообучают агентов методами обучения с подкреплением и сталкиваются с тем, что на сложных задачах почти все попытки неудачны. Также тем, кто работает с малыми моделями (в примере статьи, конфигурация 2B, где 98% групп состоят только из неудач).
Как это применить
Это исследовательская работа, а не готовый продукт. Идея для практики такова: помимо скалярной награды, использовать завершённые траектории как источник «привилегированной ретроспективы» и дистиллировать её в предсказания модели, сделанные до взаимодействия. Поскольку предвидение нужно только при обучении и не обязано генерироваться на этапе вывода, дополнительных шагов в работе обученного агента, судя по аннотации, не требуется. Ссылки на код или модели в аннотации нет, поэтому воспроизведение потребует чтения полной статьи.
Можно ли доверять
Все результаты, собственные заявления авторов в аннотации на странице Hugging Face Papers. Аннотация не называет авторов и организации, сами 10 задач, бенчмарки, базовые модели и конкретные базовые методы, поэтому независимо оценить цифры по этому тексту нельзя. Прирост «до 24,2 п.п.», максимум, а не типичное значение: на какой задаче он получен, аннотация не уточняет. Сравнение 0,0% и 60,6% приведено только для конфигурации 2B, а не для других масштабов.
Риски и подводные камни
Максимальный прирост и один показательный случай не говорят о том, насколько метод помогает в среднем. Выводы авторы формулируют осторожно («наши результаты предполагают»). Для оценки нужно изучить полную статью: какие именно задачи и модели использованы, насколько честны базовые методы и какой вычислительный бюджет требует дополнительное обучение предвидению.
«Предвидение служит лишь целью обучения и не обязано явно генерироваться на этапе вывода.»
— из аннотации статьи