Iris-3B: диффузия в пикселях сравнялась с латентной, но не выиграла
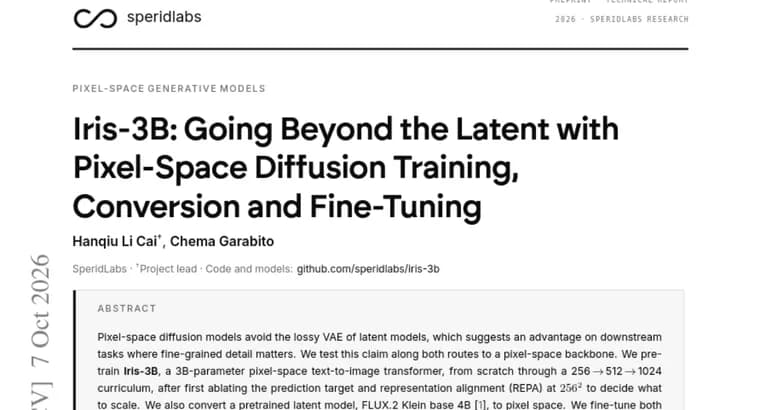
Идея работы такая: диффузионные модели в пиксельном пространстве обходятся без «lossy» (с потерями) автоэнкодера VAE, который есть у латентных моделей, поэтому логично ждать от них преимущества там, где важны мелкие детали. Авторы проверили это утверждение двумя путями к пиксельной основе.
Первый путь: они с нуля обучили Iris-3B, пиксельный трансформер для генерации картинок по тексту на 3 млрд параметров, по схеме с повышением разрешения 256, 512, затем 1024. Перед этим на разрешении 256^2 они проверяли варианты цели предсказания и выравнивание представлений (representation alignment), чтобы решить, что масштабировать. Второй путь: взять готовую латентную модель FLUX.2 Klein base 4B и конвертировать её в пиксельное пространство. Обе линейки затем дообучали для двух задач: оценки глубины по одному изображению и восстановления изображений (суперразрешения).
Результат отрицательный: значимого улучшения от пиксельного генеративного приора (предварительных знаний модели) авторы не нашли. В оценке глубины при одинаковом рецепте прямой регрессии Iris-3B на уровне латентной FLUX.2 Klein, а сконвертированная пиксельная FLUX.2 Klein отстаёт. В реставрации с увеличением в 4 раза на DIV2K ни одна из пиксельных моделей не превзошла дообученную латентную FLUX.2 Klein; сконвертированная уступает ей слегка. Авторы описывают рецепты, типичные сбои и оставшиеся факторы, которые могут искажать сравнение.
При этом сама Iris-3B показывает, что предобучение в пикселях с головой pixel-transformer (PiT) из PixelDiT масштабируется до 3 млрд параметров и даёт качество генерации по тексту, конкурентное с латентными моделями: на бенчмарке OneIG при разрешении 1024^2 и официальных оценщиках она сравнялась с Qwen-Image. Веса и код обучения авторы публикуют в надежде, что это поможет дальнейшим работам по генерации в пиксельном пространстве.
Ключевые факты
- Iris-3B: пиксельный трансформер для генерации картинок по тексту на 3 млрд параметров, обучен с нуля по схеме разрешений 256, 512, 1024.
- Вторая ветвь: латентная FLUX.2 Klein base 4B конвертирована в пиксельное пространство; обе линейки дообучали для оценки глубины и для реставрации/суперразрешения.
- Значимого выигрыша от пиксельного генеративного приора авторы не нашли: в глубине Iris-3B на уровне латентной FLUX.2 Klein, а конвертированная пиксельная отстаёт.
- В реставрации 4x на DIV2K ни одна пиксельная модель не превзошла латентную FLUX.2 Klein, конвертированная уступает слегка.
- Для генерации по тексту Iris-3B конкурентна латентным моделям: на OneIG при 1024^2 равна Qwen-Image; веса и код обучения публикуются.
Почему это важно
Довод в пользу пиксельных диффузионных моделей звучит естественно: нет потерь на VAE, значит, лучше мелкие детали. Работа проверяет его на практике и получает отрицательный результат: на оценке глубины и реставрации значимого улучшения нет. Одновременно она показывает, что пиксельное предобучение масштабируется до 3 млрд параметров и в генерации по тексту выходит на уровень латентных моделей.
Кому это важно
Исследователям диффузионных моделей, которые выбирают между латентным и пиксельным пространством, и тем, кто дообучает генеративные модели под задачи вроде оценки глубины и суперразрешения. Результат полезен и как отрицательный: он экономит силы тем, кто рассчитывал на автоматический выигрыш от отказа от VAE.
Как это применить
Авторы публикуют веса Iris-3B и код обучения; где именно и на каких условиях, в доступном тексте не сказано. Описанные рецепты (схема разрешений, абляции цели предсказания, конвертация латентной модели в пиксельную) можно использовать как отправную точку для собственных экспериментов с пиксельной генерацией.
Можно ли доверять
Это препринт, и пересказ основан на его аннотации. Числовых метрик в ней нет: сравнения даны только словами, поэтому масштаб различий оценить нельзя. Сами авторы оговаривают, что остаются неустранённые факторы, способные влиять на сравнение. Утверждение о паритете с Qwen-Image относится к бенчмарку OneIG при 1024^2 и официальным оценщикам.
Риски и подводные камни
Вывод «нет значимого улучшения» относится только к двум проверенным задачам, оценке глубины и реставрации, и не означает, что пиксельные модели хуже вообще. Сравнение зависит от конкретных рецептов дообучения и от оставшихся факторов, которые авторы упоминают. Сконвертированная пиксельная модель в обеих задачах отстаёт, так что способ получения пиксельной основы, судя по результатам, имеет значение.
«Мы не обнаружили значимого улучшения от использования генеративного приора в пиксельном пространстве.»
— из аннотации работы об Iris-3B