Learn2Play Bench: тест, учатся ли ИИ-агенты на опыте в новых играх
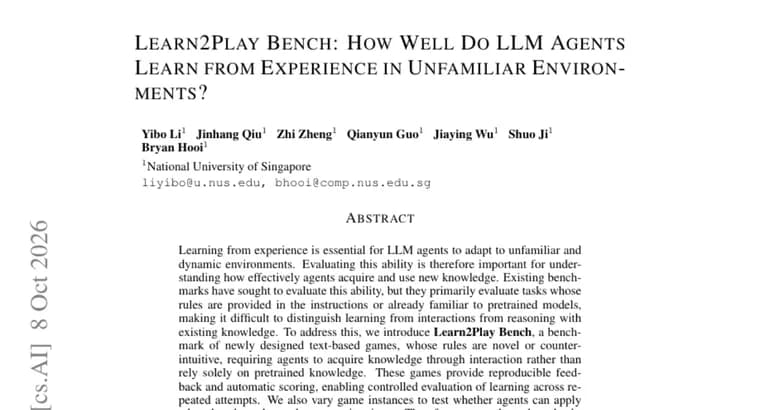
Авторы работы исходят из того, что умение учиться на опыте нужно ИИ-агентам на больших языковых моделях, чтобы приспосабливаться к незнакомым и меняющимся средам. Существующие тесты в основном проверяют задачи, правила которых даны в инструкции или уже знакомы предобученным моделям. Из-за этого трудно отличить обучение в ходе взаимодействия от рассуждений на основе уже имеющихся знаний.
Чтобы это исправить, авторы предлагают Learn2Play Bench, набор специально придуманных текстовых игр с новыми или контринтуитивными правилами. Агент должен добывать знания через взаимодействие, а не опираться только на то, что усвоила модель при предобучении. Игры дают воспроизводимую обратную связь и автоматический подсчёт очков, поэтому можно в контролируемых условиях оценивать, как агент учится от попытки к попытке. Кроме того, авторы меняют экземпляры игр, чтобы проверить, умеет ли агент переносить выученное на новые ситуации.
В оценке сравнивались базовые модели, самоэволюционирующие методы (self-evolving) и обвязки агентов (harness, программная оболочка вокруг модели). Результатов три.
-
Сохранение опыта. Хранение полных записей действий и обратной связи может обеспечить более эффективное обучение, чем сжатие этого опыта в правила или стратегии.
-
Разрыв между человеком и агентом. Лучшие игроки-люди достигают более высоких пиковых результатов, чем проверенные агенты. Люди пробуют более разнообразные стратегии и реже повторяют одни и те же действия.
-
Обвязка имеет значение. При фиксированной базовой модели смена обвязки может улучшить результат и одновременно снизить оценочную стоимость вывода.
По мнению авторов, эти выводы показывают, как ИИ-агенты учатся на опыте, и подсказывают направления для дальнейшей работы по улучшению их обучаемости. В тексте указан сайт проекта: liushiliushi.github.io/learn2play-bench-website.
Ключевые факты
- Learn2Play Bench, набор новых текстовых игр с новыми или контринтуитивными правилами, где агент должен учиться только через взаимодействие, а не по знаниям из предобучения.
- Игры дают воспроизводимую обратную связь и автоматический подсчёт очков; экземпляры игр варьируют, чтобы проверить перенос выученного на новые ситуации.
- Полные записи действий и обратной связи могут давать более эффективное обучение, чем сжатие опыта в правила или стратегии.
- Лучшие игроки-люди набирают более высокие пиковые очки, чем проверенные агенты, пробуют более разнообразные стратегии и реже повторяют действия.
- При фиксированной базовой модели смена обвязки агента может улучшить результат и снизить оценочную стоимость вывода.
Почему это важно
Многие тесты для ИИ-агентов не позволяют понять, чему агент научился в ходе работы, а что просто знал заранее: правила задач там либо даны в инструкции, либо знакомы предобученным моделям. Learn2Play Bench пытается разделить эти два вклада с помощью игр, правила которых новые или противоречат интуиции. Так проверяется именно способность учиться на опыте, а не вспоминать выученное.
Кому это важно
Исследователям агентных систем и тем, кто строит агентов с памятью и самообучением: работа сравнивает базовые модели, самоэволюционирующие методы и обвязки. Разработчикам агентов полезен вывод про память: хранение полных записей может оказаться эффективнее, чем их сжатие в правила. Тем, кто считает бюджет на вывод, интересен третий результат, смена обвязки при той же модели может снизить оценочную стоимость.
Как это применить
Прямой инструкции по применению в тексте нет. Практически из работы следует проверить в собственном агенте, не теряется ли полезная информация при пересказе опыта в краткие правила, и попробовать другие варианты обвязки при той же модели. Подробности и материалы проекта стоит искать на его сайте: liushiliushi.github.io/learn2play-bench-website.
Можно ли доверять
Это описание работы со страницы статьи; ниже пересказаны утверждения самих авторов. В тексте не названы авторы и организации, не приведены названия моделей, значения очков, цифры по стоимости и число игр. Размер разрыва между людьми и агентами не указан, а первый вывод сформулирован осторожно («может»), без количественного превосходства. Проверить результаты можно только по полной статье и материалам проекта.
Риски и подводные камни
Стоимость вывода названа «оценочной», способ оценки не раскрыт. Не сказано, какие именно самоэволюционирующие методы и обвязки сравнивались, поэтому обобщать выводы на другие системы нельзя. Превосходство людей описано только для лучших игроков и пиковых очков, а не для среднего результата. Игры текстовые, и перенос выводов на другие среды из текста не следует.