Самоорганизующиеся команды ИИ-агентов обошли сильнейшего участника в решении задач
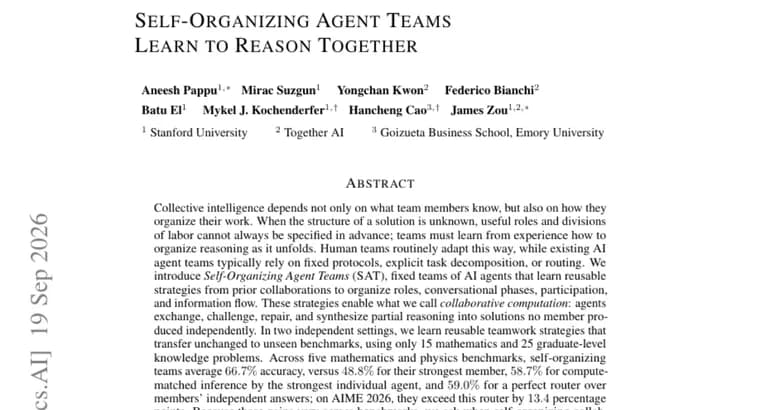
Учёные представили метод Self-Organizing Agent Teams (SAT, «самоорганизующиеся команды агентов»), фиксированные группы ИИ-агентов, которые учатся многоразовым стратегиям совместной работы: как распределять роли, выстраивать фазы обсуждения, определять, кто и когда участвует, и как обмениваться информацией. По словам авторов, вместо жёстких протоколов или маршрутизации задач агенты учатся обмениваться, оспаривать, чинить и объединять частичные рассуждения друг друга, получая решения, которые ни один участник не нашёл бы в одиночку.
Стратегии совместной работы команда SAT выучивает всего на 15 задачах по математике и 25 задачах повышенной сложности (уровня выпускных экзаменов) в двух независимых экспериментальных условиях, а затем переносит эти стратегии без изменений на незнакомые ей ранее тесты. На пяти математических и физических бенчмарках самоорганизующиеся команды в среднем показали точность 66,7%, против 48,8% у самого сильного участника команды, 58,7% при том же объёме вычислений, отданном этому же агенту в одиночку, и 59,0% у «идеального маршрутизатора», который всегда безошибочно выбирает лучший из независимых ответов участников. На тесте AIME 2026 команды превзошли этот идеальный маршрутизатор на 13,4 процентного пункта.
Поскольку выигрыш от командной работы на разных тестах различается, авторы отдельно проверили, когда самоорганизация даёт наибольший эффект. На восьми бенчмарках они обнаружили сильную связь между так называемой «демонстрируемостью», понятием из организационной психологии, означающим, насколько легко команда может отличить верное рассуждение от ошибочного, и приростом точности относительно сильнейшего участника: коэффициент корреляции Спирмена составил 0,90 при p=0,005. Иными словами, команды выигрывают больше всего тогда, когда правильное рассуждение легко распознать, как только оно появляется. Общий вывод авторов: сама организация работы может стать отдельной способностью ИИ-агента, а не просто следствием силы отдельной модели.
Ключевые факты
- SAT, фиксированные команды ИИ-агентов, которые учатся стратегиям ролей, фаз обсуждения и обмена информацией всего на 15 задачах по математике и 25 задачах повышенной сложности, а затем переносят эти стратегии без изменений на новые тесты
- На пяти математических и физических бенчмарках команды показали среднюю точность 66,7% против 48,8% у сильнейшего участника, 58,7% при том же объёме вычислений на одного агента и 59,0% у идеального алгоритма выбора лучшего ответа
- На тесте AIME 2026 команды обошли идеальный алгоритм выбора на 13,4 процентного пункта
- На восьми бенчмарках выявлена сильная связь (Спирмен ρ=0,90, p=0,005) между «демонстрируемостью» задачи, способностью распознать верное рассуждение, и приростом точности от командной работы
- Авторы заключают, что организация совместной работы сама по себе может быть отдельной способностью ИИ-агентов
Почему это важно
Работа показывает, что прирост качества у мультиагентных систем можно получить не только за счёт более сильных моделей или большего объёма вычислений, а за счёт того, как именно агенты организуют совместную работу, распределяют роли, фазы обсуждения и обмен информацией. Авторы прямо формулируют это как отдельную способность агента, которую можно выучить и перенести на новые задачи без переобучения.
Кому это важно
Прежде всего исследователям и разработчикам мультиагентных ИИ-систем, которые ищут способы повысить качество ответов без наращивания размера моделей или количества вычислений на запрос. Также интересно тем, кто изучает перенос стратегий сотрудничества между разными типами задач.
Как это применить
Метод описан как исследовательский результат, а не готовый продукт: стратегия совместной работы выучивается один раз на небольшом наборе из 15 математических и 25 более сложных задач, а затем без изменений применяется к незнакомым бенчмаркам, потенциально это способ переиспользовать однажды выученные шаблоны координации агентов в новых доменах, не тратя ресурсы на повторное обучение под каждую задачу.
Можно ли доверять
Источник, препринт научной статьи на HuggingFace Papers с числовыми результатами экспериментов, но в доступном тексте не указаны ни авторы, ни их организации, ни дата публикации, поэтому независимо оценить репутацию авторов или институтов по этому фрагменту нельзя. Восемь бенчмарков, использованных для анализа «демонстрируемости», по имени не перечислены за исключением AIME 2026.
Риски и подводные камни
Прирост точности от самоорганизации сильно варьируется между бенчмарками и, по данным авторов, зависит от того, насколько легко в конкретной задаче распознать правильное рассуждение, то есть метод не даёт равномерного выигрыша везде. Кроме того, в тексте не описан механизм того, как именно выученные стратегии представляются и хранятся между разными сессиями сотрудничества, что затрудняет оценку воспроизводимости и переносимости метода на практике.
«Организация работы сама по себе может стать способностью агента.»
— авторы исследования