Google представила систему из четырёх ИИ-агентов для связного длинного видео на Gemini и Veo
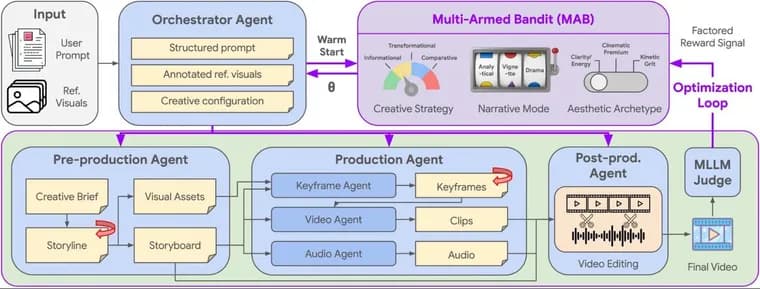
24 сентября 2026 года научные сотрудники Google Йель Сонг (Yale Song) и Ивэнь Сонг (Yiwen Song) опубликовали в блоге Google Research статью о новой архитектуре для генерации длинных, связных по сюжету видео. Проблема, которую они решают: существующие агентные конвейеры генерации видео собирают ролик из отдельных модулей с независимыми, вручную написанными подсказками, из-за чего возникает «семантический дрейф» (например, одежда или интерьер персонажа незаметно меняются от кадра к кадру) и каскадные ошибки, когда артефакт на одном этапе портит все последующие кадры. Авторы предлагают четыре взаимосвязанных компонента, работающих как надстройка (orchestration layer) поверх моделей Gemini и Veo. Первый, AI video co-director, иерархическая мультиагентная система, которая формализует создание видео как задачу глобальной оптимизации: агент-оркестратор с помощью алгоритма многорукого бандита выбирает творческую стратегию, повествовательный режим и визуальную эстетику, а затем агенты подготовки, продакшена (кадры, видео, звук) и ИИ-судья на основе мультимодальной модели оценивают результат и уточняют выбор в цикле. Эта система достигла пикового показателя качества 81,4 на бенчмарке GenAD-Bench и работу над ней покажут на конференции COLM 2026. Второй компонент, CANVAS (Continuity-Aware Narratives via Visual Agentic Storyboarding), который хранит структурированную «визуальную память» о персонажах, локациях и предметах, чтобы они не менялись при повторном появлении в кадре; статья о нём выйдет на EMNLP 2026. В сравнении на сцене «ограбление музея» CANVAS сохранял единый облик вора, зала и драгоценного камня, тогда как обычная генерация через Gemini-3.1-Pro и альтернативный фреймворк AutoStudio теряли детали одежды и фона. Третий компонент, A²RD, агентная архитектура авторегрессивной генерации видео посегментно, которая хранит мультимодальную память о контексте и динамике сюжета и переключается между «экстраполяцией» (движение сюжета вперёд) и «интерполяцией» (привязка к уже показанным персонажам и локациям). Для демонстрации авторы показали десятиминутный ролик, где персонажи и декорации сохраняют узнаваемость от первого до последнего кадра, в отличие от обычных генераторов видео, страдающих от визуального «распада». Четвёртый компонент, VQQA (Video Quality Question Answering), система, которая задаёт видео визуальные вопросы, использует ответы визуально-языковой модели как «смысловой градиент» для итеративного улучшения текстового промпта (а не самих пикселей) и через механизм глобального отбора выбирает лучший вариант из всей траектории оптимизации, а не просто последнюю версию. Поскольку весь фреймворк построен поверх Gemini и Veo, он, по словам авторов, автоматически наследует встроенные механизмы безопасности, включая водяные знаки SynthID, а для готового ролика дополнительно можно применять классификаторы безопасности, чтобы отловить нежелательные сочетания сами по себе безопасных кадров. Точных числовых показателей качества для CANVAS, A²RD и VQQA на их бенчмарках (ST-Bench, HardContinuityBench, VBench-Long, LVBench-C, T2V-CompBench, VBench2, VBench-I2V) в тексте блога не приведено, только общие формулировки об улучшении по сравнению с базовыми методами. Сроков публичного выпуска или доступа разработчикам к этим инструментам в материале не указано.
Ключевые факты
- Google Research 24 сентября 2026 года представила единый мультиагентный фреймворк для генерации длинного, сюжетно связного видео поверх моделей Gemini и Veo; авторы, научные сотрудники Google Йель Сонг и Ивэнь Сонг
- Фреймворк состоит из четырёх компонентов: AI video co-director (доклад на COLM 2026), CANVAS (доклад на EMNLP 2026), A²RD и VQQA
- AI video co-director набрал пиковый показатель качества 81,4 на бенчмарке GenAD-Bench
- A²RD показал десятиминутный демонстрационный ролик, сохраняющий внешность персонажей и декораций от начала до конца
- Система наследует встроенные средства безопасности Gemini и Veo, включая водяные знаки SynthID, и допускает дополнительные классификаторы безопасности для готового видео
Почему это важно
Диффузионные модели уже генерируют качественные короткие клипы за секунды, но склейка их в связный длинный сюжет остаётся проблемой: при цепочке независимых модулей персонажи и обстановка незаметно «уплывают» от кадра к кадру, а ошибка на одном шаге портит всё, что генерируется дальше. Google предлагает решить это не точечными патчами, а единой архитектурой, которая с самого начала планирует визуальную преемственность и отслеживает состояние «мира» истории, персонажей, локаций и предметов, на всём протяжении ролика.
Кому это важно
Материал адресован исследователям генеративного видео, разработчикам инструментов на базе Gemini и Veo, а также студиям и создателям контента, которые в перспективе могут получить более надёжные инструменты для автоматизированного производства многоминутных видеороликов с устойчивым сюжетом.
Как это применить
Речь идёт об исследовательских фреймворках, а не о готовом продукте: сроков публичного или разработческого доступа к AI video co-director, CANVAS, A²RD и VQQA в материале не названо. Часть работы будет представлена на профильных конференциях, Co-Director на COLM 2026, CANVAS на EMNLP 2026, где можно ожидать более подробного описания архитектур и условий обучения.
Можно ли доверять
Это официальный пост в блоге Google Research с указанием имён и должностей авторов (научные сотрудники Google), подробным описанием архитектуры и ссылками на предстоящие публикации на COLM и EMNLP 2026. При этом числовой показатель качества (81,4 на GenAD-Bench) приведён только для одного из четырёх компонентов, для CANVAS, A²RD и VQQA в тексте даны лишь качественные утверждения об улучшении без конкретных цифр.
Риски и подводные камни
Пока это исследовательский прототип без объявленной даты выхода, неизвестно, доберётся ли технология до продуктов вроде Veo в обозримом будущем. Сложная многоагентная архитектура с несколькими циклами уточнения потенциально требует значительных вычислительных ресурсов. Кроме того, несмотря на наследуемые водяные знаки SynthID и заявленные дополнительные классификаторы безопасности, более убедительная генерация длинных связных видео повышает риск использования технологии для реалистичных фейковых роликов.
«Большинство существующих агентных конвейеров автоматизируют этот процесс через цепочки модулей, но страдают от семантического дрейфа (незаметных изменений в одежде персонажа или декорациях между кадрами) и каскадных ошибок (например, когда артефакт на раннем этапе портит синтез видео на последующих) из-за независимых, вручную составленных подсказок.»
— авторы исследования, Google Research