Представлен ZeroVLN: навигация без дообучения визуально-языковой модели
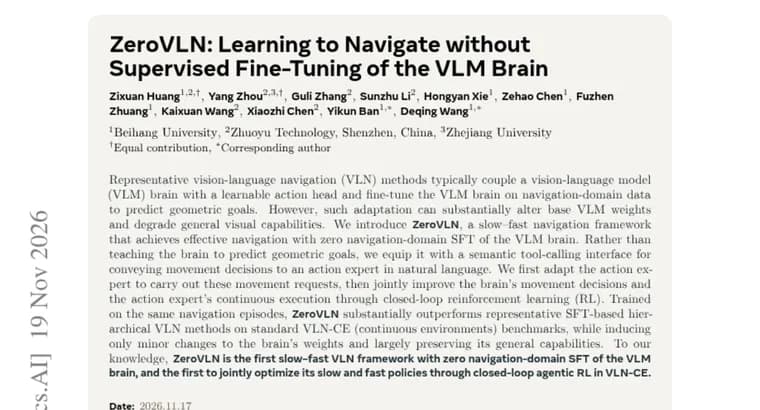
Авторы статьи, опубликованной на Hugging Face Papers, описывают ZeroVLN, «медленно-быстрый» (slow-fast) фреймворк для навигации по языковым инструкциям (VLN, vision-language navigation). Главная особенность: у визуально-языковой модели (VLM), которая играет роль «мозга», нет никакого контролируемого дообучения (SFT) на навигационных данных.
Отправная точка, критика типичного подхода. По словам авторов, характерные VLN-методы соединяют VLM-«мозг» с обучаемой «головой действий» и дообучают сам «мозг» на навигационных данных, чтобы он предсказывал геометрические цели. Такая адаптация, пишут авторы, может заметно изменить веса базовой VLM и ухудшить её общие визуальные способности.
ZeroVLN устроен иначе. Вместо того чтобы учить «мозг» предсказывать геометрические цели, ему дают семантический интерфейс вызова инструментов (tool calling): через него модель передаёт решения о движении «эксперту по действиям» (action expert) обычным естественным языком.
Обучение идёт в два этапа. Сначала эксперта по действиям адаптируют так, чтобы он выполнял такие запросы на движение. Затем решения «мозга» и непрерывное исполнение движений экспертом совместно улучшают замкнутым (closed-loop) обучением с подкреплением (RL).
Результат, по заявлению авторов: при обучении на тех же навигационных эпизодах ZeroVLN существенно превосходит репрезентативные иерархические VLN-методы на основе SFT на стандартных бенчмарках VLN-CE (навигация в непрерывных средах). При этом веса «мозга» меняются лишь незначительно, а общие способности модели в основном сохраняются. Численные показатели в тексте не приведены.
Авторы также утверждают, что, насколько им известно, ZeroVLN, первый slow-fast VLN-фреймворк без навигационного SFT у VLM-«мозга» и первый, где медленная и быстрая политики совместно оптимизируются замкнутым агентным RL в VLN-CE.
Ключевые факты
- ZeroVLN, slow-fast фреймворк навигации по языковым инструкциям, в котором VLM-«мозг» не проходит навигационного SFT (контролируемого дообучения).
- Вместо предсказания геометрических целей «мозг» через семантический интерфейс вызова инструментов передаёт решения о движении эксперту по действиям на естественном языке.
- Обучение в два этапа: сначала адаптация эксперта по действиям, затем совместное улучшение «мозга» и эксперта замкнутым обучением с подкреплением.
- По заявлению авторов, на стандартных бенчмарках VLN-CE метод существенно превосходит иерархические SFT-методы при обучении на тех же эпизодах, а веса «мозга» меняются лишь слегка.
- Числовых результатов, названий базовой модели и конкретных конкурирующих методов в тексте нет.
Почему это важно
Типичный путь для навигационных агентов, дообучать большую визуально-языковую модель на навигационных данных. Авторы указывают на цену такого шага: адаптация может заметно сдвинуть веса базовой модели и ухудшить её общие визуальные способности. ZeroVLN предлагает обойтись без этого: модель остаётся почти такой, какой была, а навигационное поведение формируется в эксперте по действиям и через RL. Это попытка совместить навигацию с сохранением универсальности модели.
Кому это важно
Исследователям навигации по языковым инструкциям и агентного обучения с подкреплением, а также тем, кто строит иерархические системы «модель-планировщик плюс исполнитель». Интересно и всем, кого беспокоит потеря общих способностей VLM при узкоспециальном дообучении.
Как это применить
В тексте источника нет сведений о коде, весах или планах их публикации, поэтому воспроизвести метод по нему нельзя. Практический вывод, идея архитектуры: «мозг» говорит с исполнителем на естественном языке через интерфейс вызова инструментов, а не выдаёт геометрические координаты. Подробности нужно искать в полном тексте статьи.
Можно ли доверять
Все утверждения, самооценка авторов статьи; независимой проверки в источнике нет. Формулировка «существенно превосходит» не подкреплена числами: не названы метрики, доли успеха и конкретные методы сравнения. Утверждение о «минимальных изменениях весов» и «в основном сохранённых общих способностях» также не количественно. Заявленный приоритет («первый в своём роде») дан с оговоркой «насколько нам известно». Источник, страница препринта на Hugging Face Papers; имён авторов и организаций в тексте нет.
Риски и подводные камни
Превосходство над конкурентами заявлено по сравнению с иерархическими методами на основе SFT и только на бенчмарках VLN-CE; в тексте не упомянуто ни реальных роботов, ни применения в реальном мире. Не указаны объём обучающих данных, вычислительные затраты и базовая модель, поэтому оценить цену и переносимость подхода нельзя. Описание дано по краткой аннотации, детали реализации в ней отсутствуют.
«Насколько нам известно, ZeroVLN, первый slow-fast фреймворк VLN без навигационного SFT у VLM-«мозга» и первый, в котором его медленная и быстрая политики совместно оптимизируются замкнутым агентным RL в VLN-CE.»
— Авторы статьи, Hugging Face Papers