Представлен Mind2Act World: лучший ИИ-агент решает лишь 12% составных задач
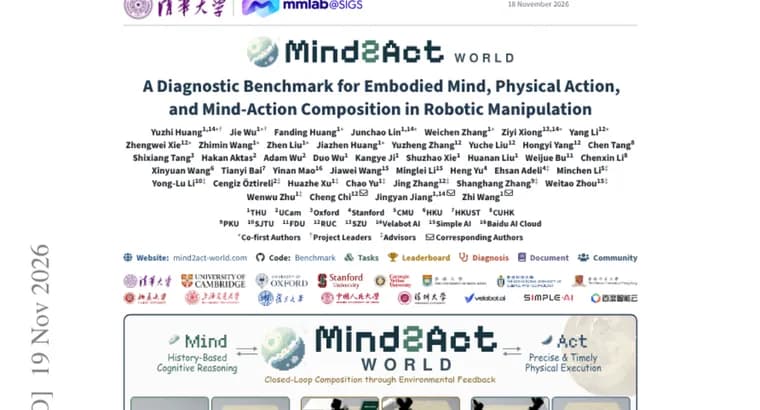
Авторы работы представили Mind2Act World, диагностический бенчмарк из 30 симулированных задач манипулирования, взятых из пяти прикладных областей реального мира. У каждой задачи три уровня сложности и два варианта сцены (Clean и Random), так что всего получается 180 конфигураций.
Идея в том, чтобы понять, почему именно робот проваливает задачу. По словам авторов, существующие бенчмарки либо проверяют рассуждение и исполнение в одних и тех же задачах, либо оценивают их по отдельности, не проверяя их сочетание, поэтому по ним почти не видно, откуда берётся ошибка: из рассуждения, из исполнения или из их сочетания. Задачи Mind2Act World разделены на три «взгляда». Mind проверяет решения, принимаемые на основе прошлых наблюдений. Act проверяет точное и своевременное исполнение движений. Mind2Act объединяет оба умения в задачах с замкнутым контуром, где результаты действий влияют на последующие решения. Сравнение трёх взглядов показывает, не хватает ли системе самой способности или она не умеет сочетать способности, которые у неё уже есть.
Для трёх репрезентативных систем авторы добавили диагностический модуль (diagnosis harness): он относит неудачные эпизоды к Mind, к Act или к их сочетанию и сводит результат по каждой системе в профильную карточку.
Оценивались мультимодальные агенты, vision-language-action модели (VLA) и world-action модели (WAM). Главный вывод: успех в одном из взглядов не переносится на задачи Mind2Act. Даже сильнейший агент выполняет 52,7% эпизодов Mind и 39,0% эпизодов Act, но только 12,0% эпизодов Mind2Act. По описанию авторов, сильнейший агент удерживает состояние задачи, но с трудом справляется с продолжительным контактом, а сквозные (end-to-end) политики исполняют отработанные движения, но почти не помнят состояние задачи. Авторы заключают, что главная нерешённая проблема, объединение рассуждения и исполнения через обратную связь со средой.
Ключевые факты
- Mind2Act World, диагностический бенчмарк из 30 симулированных задач манипулирования из пяти прикладных областей; три уровня сложности и два варианта сцены (Clean и Random) дают 180 конфигураций.
- Задачи делятся на три взгляда: Mind (решения по прошлым наблюдениям), Act (точное и своевременное исполнение) и Mind2Act (оба умения в замкнутом контуре с обратной связью).
- Сильнейший агент успешен в 52,7% эпизодов Mind и 39,0% эпизодов Act, но лишь в 12,0% эпизодов Mind2Act.
- Сильнейший агент удерживает состояние задачи, но слаб в продолжительном контакте; сквозные политики исполняют отработанные движения, но почти не помнят состояние задачи.
- Диагностический модуль относит неудачи трёх систем к рассуждению, исполнению или их сочетанию и строит профильную карточку каждой.
Почему это важно
Обычно робота оценивают одной цифрой успеха, и по ней не понять, чего ему не хватает: умения рассуждать, умения точно двигаться или умения связать одно с другим. Mind2Act World разделяет эти вещи. Главный результат: способность в одном «взгляде» не переносится на составную задачу, у сильнейшего агента 52,7% и 39,0% успеха по отдельности против 12,0% в совместных задачах. Авторы делают вывод, что главная нерешённая проблема, объединение рассуждения и исполнения через обратную связь со средой.
Кому это важно
Исследователям в области воплощённого ИИ и робототехники манипулирования, которые сравнивают мультимодальных агентов, vision-language-action модели (VLA) и world-action модели (WAM). Также тем, кто выбирает между сильнейшим агентом и сквозными политиками: бенчмарк показывает типичные слабые места каждого из них.
Как это применить
Бенчмарк можно использовать как диагностический инструмент: прогнать систему по трём взглядам и сравнить результаты, чтобы понять, не хватает ли ей способности или она не умеет сочетать уже имеющиеся. Профильная карточка, которую строит диагностический модуль, показывает, куда направлять доработки, в память о состоянии задачи, в устойчивый контакт или в связку между ними. Сведений о публикации кода, данных и таблицы лидеров в тексте источника нет.
Можно ли доверять
Это аннотация научной работы на Hugging Face, и все выводы принадлежат самим авторам. В аннотации не названы авторы и организации, не названы сильнейший агент и конкретные оцениваемые модели, не указано число эпизодов на конфигурацию и способ агрегации успеха, а также не названы пять прикладных областей. Результаты приведены только для сильнейшего агента; по VLA и WAM процентов нет. Задачи только симулированные, результаты на реальных роботах не приводятся.
Риски и подводные камни
Цифры 52,7%, 39,0% и 12,0% относятся к одному, самому сильному агенту, а не ко всем системам, и не раскрыто, как именно они посчитаны. Это симулированные задачи, поэтому неясно, как выводы перенесутся на физических роботов. Деление неудач на Mind, Act и их сочетание сделано диагностическим модулем лишь для трёх систем, так что обобщать на весь класс моделей стоит осторожно.
«Эти результаты указывают, что главная нерешённая проблема, объединение рассуждения и исполнения через обратную связь со средой.»
— Из аннотации к работе Mind2Act World