Представлена HiUni: общая основа для понимания и генерации изображений
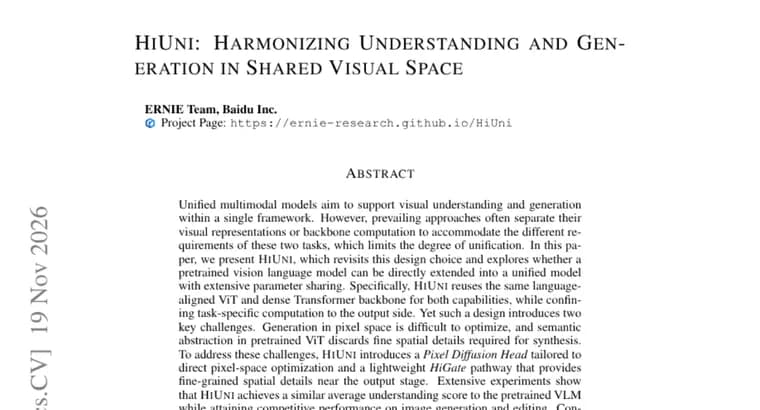
Мультимодальные модели, которые умеют и понимать изображения, и создавать их, обычно разделяют визуальные представления или вычисления в основной сети для двух задач, потому что у задач разные требования. По словам авторов статьи, из-за этого степень объединения получается ограниченной.
HiUni пересматривает такой подход. Авторы проверяют, можно ли напрямую расширить уже обученную модель, работающую с изображениями и текстом (vision language model, VLM), до единой модели с максимальным совместным использованием параметров. Для этого HiUni использует один и тот же ViT (визуальный кодировщик, согласованный с языком) и одну плотную Transformer-основу и для понимания, и для генерации. Специфичные для задачи вычисления вынесены только на выходную сторону.
Такая схема создаёт две проблемы. Во-первых, генерацию прямо в пространстве пикселей трудно оптимизировать. Во-вторых, смысловая абстракция в предобученном ViT отбрасывает мелкие пространственные детали, которые нужны для синтеза изображения.
Для решения авторы добавляют два компонента. Pixel Diffusion Head, выходная часть, рассчитанная на прямую оптимизацию в пространстве пикселей. HiGate, лёгкий путь, который подаёт мелкие пространственные детали ближе к выходу модели.
Результаты авторы описывают так: по среднему баллу понимания HiUni близка к исходной предобученной VLM, а в генерации и редактировании изображений показывает конкурентоспособное качество. Контролируемые сравнения и анализ, по их выводу, показывают, что один плотный backbone (основная сеть) может обеспечивать обе способности без отдельных вычислений в основе для каждой задачи. Это, как считают авторы, указывает на более простой путь к унифицированным мультимодальным моделям.
Ключевые факты
- HiUni расширяет предобученную модель «зрение плюс язык» до генерации и редактирования изображений, не заводя отдельную основу под каждую задачу.
- Для понимания и генерации используются один и тот же ViT, согласованный с языком, и одна плотная Transformer-основа; задачно-специфичные вычисления вынесены на выход.
- Две заявленные проблемы такой схемы: генерацию в пространстве пикселей трудно оптимизировать, а семантическая абстракция ViT теряет мелкие пространственные детали.
- Решения: Pixel Diffusion Head для прямой оптимизации в пикселях и лёгкий путь HiGate, который подаёт мелкие детали ближе к выходу.
- По словам авторов, средний балл понимания близок к исходной VLM, а генерация и редактирование изображений показывают конкурентоспособный результат.
Почему это важно
Идея в том, чтобы не строить для понимания и генерации изображений две разные основы, а обойтись одной. По утверждению авторов, многие нынешние подходы разделяют визуальные представления или вычисления в основной сети, и это ограничивает унификацию. HiUni предлагает более простой путь: взять готовую VLM и дополнить её только на выходе. Если вывод подтвердится, мультимодальные системы можно будет строить проще.
Кому это важно
Исследователям мультимодальных моделей, которые занимаются единым подходом к пониманию и генерации изображений, и командам, которые думают о расширении готовых VLM генерацией и редактированием картинок. Для обычных пользователей это пока научная работа, а не продукт.
Как это применить
Напрямую применять пока нечего. В тексте описана архитектурная идея: общий ViT и плотная Transformer-основа плюс Pixel Diffusion Head и путь HiGate. Кода, весов и сведений о выпуске в тексте не упоминается. Практическая польза сейчас в том, чтобы взять схему как ориентир при проектировании собственной унифицированной модели.
Можно ли доверять
Все утверждения, приведённые здесь, взяты из аннотации самой статьи, то есть это заявления авторов. Авторы и организации в тексте не названы, числовых баллов, названий тестов и конкретных моделей для сравнения нет: понимание описано как «схожее» с исходной VLM, генерация и редактирование, как «конкурентоспособные». Само слово «конкурентоспособные» не означает лучший результат. Проверить заявления по этому тексту нельзя.
Риски и подводные камни
Без цифр нельзя оценить, насколько именно HiUni уступает или не уступает исходной VLM по пониманию и другим моделям по генерации. Заявлено лишь «схожее» среднее понимание. Сами авторы признают две трудности общей основы: оптимизацию в пикселях и потерю мелких деталей в ViT, и их решения (Pixel Diffusion Head и HiGate) ещё нужно проверять независимо.