Представлен YANAMI: датасет и бенчмарк из 400 тысяч мультимодальных диалогов
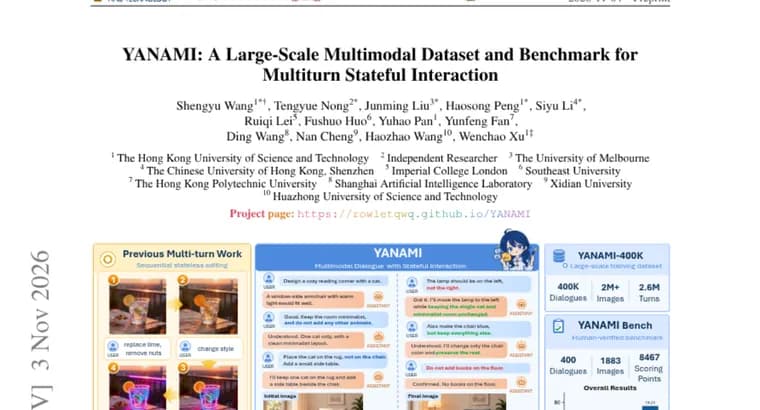
Статья на Hugging Face Papers представляет YANAMI, набор данных и бенчмарк для «мультимодальных диалогов с состоянием» (stateful interaction). Речь о единых мультимодальных моделях (UMM), которые в одной архитектуре объединяют понимание изображений, их генерацию и редактирование. По мнению авторов, существующие датасеты и бенчмарки для таких моделей в основном состоят из одношаговых задач. Даже в недавних многошаговых наборах многие реплики можно решить независимо друг от друга, не отслеживая информацию из предыдущих ходов. Поэтому они дают ограниченный обучающий сигнал и слабо проверяют главное: умение понимать, поддерживать, обновлять и точно воплощать в картинках меняющееся от хода к ходу состояние диалога.
Чтобы закрыть этот пробел, авторы вводят YANAMI, который называют первым крупномасштабным мультимодальным диалоговым датасетом и бенчмарком для такого взаимодействия. Он состоит из двух частей. YANAMI-400K, обучающая часть: 400 тысяч многошаговых мультимодальных диалогов, более 2 млн изображений и 2,6 млн реплик (ходов диалога). Диалоги охватывают четыре сценария: слияние нескольких изображений (Multi-Image Fusion), редактирование изображений (Image Editing), моделирование мира (World Modeling) и визуальные рассуждения (Visual Reasoning). От модели требуется непрерывно отслеживать, сохранять и пересматривать состояние диалога на протяжении ходов.
YANAMI-Bench, оценочная часть: 400 многошаговых диалогов. Бенчмарк одновременно проверяет два навыка: понимание состояния диалога (Dialogue State Understanding) и визуальное воплощение (Visual Realization). Так он показывает разрыв между способностью модели понять, как меняется состояние беседы, и способностью верно отразить это в выдаваемых изображениях.
Эксперименты: дообучение модели BAGEL на YANAMI-400K улучшает редактирование изображений, генерацию и мультимодальное взаимодействие с состоянием на 10,3%, 2,0% и 13,23% соответственно, при этом общие способности модели к визуальному пониманию сохраняются. Оценка на YANAMI-Bench, по словам авторов, показывает, что существующие единые мультимодальные модели по-прежнему плохо справляются с тем, чтобы поддерживать, обновлять и визуально воплощать эволюционирующее состояние мультимодального диалога.
Ключевые факты
- YANAMI состоит из обучающей части YANAMI-400K (400 тысяч многошаговых диалогов, более 2 млн изображений, 2,6 млн реплик) и бенчмарка YANAMI-Bench (400 диалогов).
- Диалоги охватывают четыре сценария: слияние нескольких изображений, редактирование изображений, моделирование мира и визуальные рассуждения.
- Бенчмарк раздельно оценивает понимание состояния диалога и визуальное воплощение этого состояния в картинках.
- Дообучение BAGEL на YANAMI-400K улучшило редактирование изображений на 10,3%, генерацию на 2,0% и мультимодальное взаимодействие с состоянием на 13,23%, сохранив общее визуальное понимание.
- Существующие единые мультимодальные модели, по результатам авторов, всё ещё плохо удерживают и обновляют состояние диалога.
Почему это важно
Единые мультимодальные модели учатся и проверяются в основном на одношаговых заданиях, тогда как реальная работа с картинками, это диалог: «убери это», «а теперь сделай вот так», «верни как было». Авторы YANAMI утверждают, что во многих существующих многошаговых наборах реплики решаются независимо, то есть память о предыдущих ходах не нужна. YANAMI задуман как набор, где без отслеживания состояния диалога не обойтись, и как бенчмарк, который это измеряет. Это направление исследований, а не готовый продукт.
Кому это важно
В первую очередь исследователям и разработчикам единых мультимодальных моделей, которые объединяют понимание, генерацию и редактирование изображений. Бенчмарк может заинтересовать тех, кто сравнивает такие модели в многошаговых сценариях: слияние изображений, редактирование, моделирование мира, визуальные рассуждения. Обычному пользователю материал напрямую ничего не даёт.
Как это применить
Данных о доступности набора, лицензии, ссылке на скачивание и выпуске кода в источнике нет, поэтому оценить практическое применение сейчас нельзя. Судя по описанию, YANAMI-400K предназначен для дообучения (авторы дообучали BAGEL), а YANAMI-Bench, для оценки моделей по двум осям: понимание состояния диалога и его визуальное воплощение. Размер и версия BAGEL в источнике не указаны.
Можно ли доверять
Все цифры и выводы, заявления самих авторов в аннотации статьи; независимой проверки в источнике нет. Утверждение «первый крупномасштабный» тоже их собственное. Источник не уточняет, считаются ли 10,3%, 2,0% и 13,23% в процентных пунктах или относительно исходного уровня, и по каким метрикам; не названы авторы и организации, не описано, как строились диалоги и изображения, и не сказано, какие ещё модели прошли YANAMI-Bench и с какими результатами.
Риски и подводные камни
Размер прироста нельзя трактовать однозначно: неизвестны метрики и базовые значения, а 2,0% по генерации выглядит скромно рядом с 10,3% и 13,23%. Бенчмарк содержит всего 400 диалогов, а набор данных новый, поэтому его устойчивость как стандарта оценки ещё предстоит проверить. Вывод о том, что существующие модели «всё ещё испытывают трудности», в источнике дан без конкретных цифр по этим моделям.