Представлен TuringSpace: GPT-6 Astra проваливает 25,9% CAPTCHA
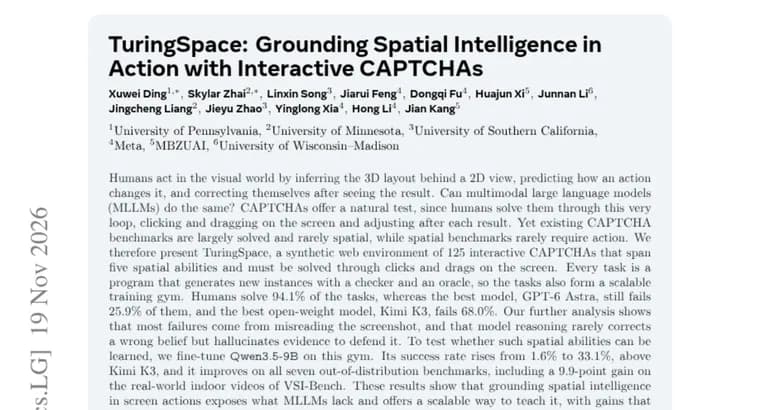
Авторы статьи исходят из того, что человек действует в визуальном мире по циклу: по плоской картинке достраивает трёхмерную раскладку, предсказывает, как действие её изменит, и поправляет себя, увидев результат. Вопрос в том, могут ли так же мультимодальные большие языковые модели (MLLM). Естественный тест для этого, CAPTCHA: люди решают их ровно по такому циклу, кликая и перетаскивая элементы на экране и корректируясь после каждого результата. При этом, по словам авторов, существующие бенчмарки на основе CAPTCHA в основном уже «решены» и редко проверяют пространственное мышление, а пространственные бенчмарки редко требуют действий.
Ответ авторов, TuringSpace, синтетическая веб-среда из 125 интерактивных CAPTCHA, охватывающих пять пространственных навыков. Задачи нужно решать кликами и перетаскиванием на экране. Каждая задача, это программа, которая порождает новые экземпляры вместе с проверяющим модулем и оракулом, поэтому набор задач одновременно служит масштабируемой тренировочной средой.
Результаты замеров: люди решают 94,1% задач, лучшая модель GPT-6 Astra всё равно проваливает 25,9%, а лучшая модель с открытыми весами Kimi K3, 68,0%. Анализ авторов показывает, что большинство ошибок связано с неверным прочтением скриншота, а рассуждения моделей редко исправляют ошибочное убеждение: вместо этого модель выдумывает свидетельства в его защиту.
Чтобы проверить, можно ли такие навыки выработать обучением, авторы дообучили Qwen3.5-9B на этой среде. Доля успешно решённых задач выросла с 1,6% до 33,1%, выше, чем у Kimi K3. Кроме того, дообученная модель улучшилась на всех семи бенчмарках вне обучающего распределения, включая прирост на 9,9 пункта на видео реальных помещений из VSI-Bench. Авторы делают вывод, что привязка пространственного интеллекта к действиям на экране выявляет, чего не хватает MLLM, и даёт масштабируемый способ этому научить, причём выигрыш переносится на реальные сцены. Они обещают выпустить TuringSpace для дальнейших исследований.
Ключевые факты
- TuringSpace, синтетическая веб-среда из 125 интерактивных CAPTCHA на пять пространственных навыков; решать нужно кликами и перетаскиванием.
- Люди решают 94,1% задач; лучшая модель GPT-6 Astra проваливает 25,9%, лучшая модель с открытыми весами Kimi K3, 68,0%.
- По анализу авторов, большинство ошибок, неверное прочтение скриншота, а рассуждения модели редко исправляют ошибку и скорее выдумывают доводы в её защиту.
- Каждая задача, программа с проверяющим модулем и оракулом, поэтому набор служит масштабируемой тренировочной средой.
- Дообучение Qwen3.5-9B подняло долю успешных решений с 1,6% до 33,1% (выше Kimi K3) и улучшило результат на всех семи внешних бенчмарках, на VSI-Bench, на 9,9 пункта.
Почему это важно
Работа показывает разрыв между людьми и сильнейшими мультимодальными моделями в простой на вид задаче: понять расположение объектов на экране и выполнить действие. Даже у лучшей модели из проверенных, GPT-6 Astra, провал составляет 25,9% при 94,1% успеха у людей. Второе наблюдение, что такие навыки поддаются обучению: небольшая модель Qwen3.5-9B после дообучения на среде перешла от 1,6% к 33,1% успеха, а улучшение перенеслось на другие бенчмарки, в том числе на видео реальных помещений.
Кому это важно
Исследователям мультимодальных моделей и пространственного мышления, а также тем, кто строит агентов, работающих с интерфейсами через клики и перетаскивание: в статье измеряется именно эта способность. Тем, кто собирает тренировочные среды, интересен сам подход, задачи-программы с генерацией новых экземпляров, проверяющим модулем и оракулом.
Как это применить
Прямого готового инструмента пока нет: авторы только обещают выпустить TuringSpace для дальнейших исследований. Практический вывод на сегодня, идея обучать модели пространственным навыкам на программно порождаемых интерактивных задачах и проверять прогресс на независимых бенчмарках вроде VSI-Bench.
Можно ли доверять
Это препринт со страницы статьи на Hugging Face; все цифры, результаты самих авторов, независимой проверки в тексте нет. Выводы о причинах ошибок моделей, это анализ авторов, а не установленный факт. Среда пока не выпущена, поэтому воспроизвести замеры нельзя. Источник не перечисляет пять пространственных навыков и не описывает метод дообучения, так что оценить его по тексту затруднительно.
Риски и подводные камни
Успех 33,1% после дообучения всё ещё сильно ниже человеческих 94,1%, поэтому говорить о закрытии разрыва рано. Перенос на семь внешних бенчмарков подтверждён в тексте только конкретной цифрой для VSI-Bench (+9,9 пункта); прирост на остальных шести не приведён. Результат измерен на синтетических CAPTCHA, и неизвестно, как он поведёт себя на настоящих веб-интерфейсах.
«привязка пространственного интеллекта к действиям на экране показывает, чего не хватает MLLM, и даёт масштабируемый способ этому научить, причём выигрыш переносится на реальные сцены»
— авторы статьи о TuringSpace