Представлена EgoCaptioner: подробные подписи к видео от первого лица с таймкодами
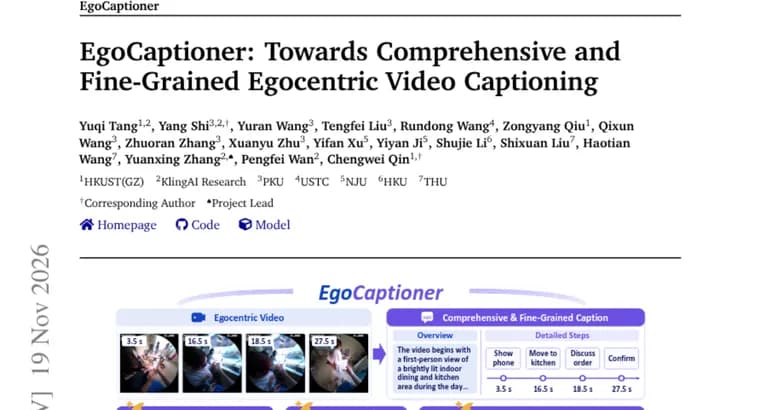
В препринте на Hugging Face представлен EgoCaptioner, подход к описанию видео, снятых от первого лица (носимая камера: видно то, что делает сам человек). Авторы статьи исходят из того, что современные мультимодальные большие языковые модели (MLLM) в такой задаче часто пропускают короткие действия, путают их порядок или неверно понимают движения человека с камерой. Существующие форматы подписей, по их словам, плохо сочетают подробное повествование с точной привязкой ко времени.
Формат подписи в EgoCaptioner состоит из двух частей: общего обзора на уровне всего видео (обстановка, участники, общее занятие владельца камеры) и последовательности шагов с таймкодами. Описание шагов подстраивается под разную перцептивную сложность момента и отмечает ключевые события в конкретные моменты времени.
Для обучения разработан конвейер аннотирования «от грубого к точному»: сначала задаётся структура событий, затем расширяются описания шагов. Он дал 50 000 обучающих примеров из восьми источников видео от первого лица. Далее подписи дорабатываются методом Group Relative Policy Optimization (GRPO), обучением с подкреплением. Используются дополняющие друг друга награды: за фактическую точность и полноту, за временное соответствие на уровне шагов, а также штраф за дробное или избыточное повествование. Чтобы фактическая разметка была надёжнее, к эталонным подписям добавлены факты о движении, полученные по позе (когда есть данные сенсоров).
Результаты, заявленные в аннотации: на пяти бенчмарках по видео от первого лица EgoCaptioner показывает лидирующие результаты среди проверенных открытых моделей по качеству подписей, по ответам на вопросы на основе подписи и по временному соответствию. Кроме того, она превосходит Gemini 3.1 Pro на PhysCapBench и все проверенные закрытые базовые модели на Minerva-Ego по протоколу «подпись → ответ на вопрос». Абляции (отключение отдельных компонентов) подтверждают, что фактические и временные награды дополняют друг друга, а аннотирование от грубого к точному даёт более эффективное обучение, чем разметка за один проход.
Ключевые факты
- Формат подписи: общий обзор видео (обстановка, участники, занятие владельца камеры) плюс шаги с таймкодами и отметками ключевых моментов.
- Обучающая выборка, 50 000 примеров из восьми источников видео от первого лица, собранных конвейером аннотирования от грубого к точному.
- Дообучение методом GRPO с наградами за фактическую точность и полноту, временное соответствие шагов и штрафом за дробное или избыточное повествование; к эталонам добавлены факты о движении по данным о позе.
- По заявлению авторов, на пяти бенчмарках лидирует среди проверенных открытых моделей, на PhysCapBench превосходит Gemini 3.1 Pro, на Minerva-Ego (протокол «подпись → ответ на вопрос»), все проверенные закрытые базовые модели.
- Абляции показывают: разметка от грубого к точному эффективнее однопроходной, а фактические и временные награды дополняют друг друга.
Почему это важно
Описание видео от первого лица, задача, где важны и мелкие детали, и точное время: короткие действия легко пропустить, а порядок шагов, перепутать. По утверждению авторов статьи, именно с этим у нынешних мультимодальных моделей проблемы. EgoCaptioner предлагает единый формат (обзор плюс шаги с таймкодами) и способ обучения под него. Отдельно заявлено превосходство над Gemini 3.1 Pro на PhysCapBench, но только на этом бенчмарке.
Кому это важно
Исследователям, которые работают с видео от первого лица, описанием видео и временной привязкой событий, а также тем, кто строит конвейеры разметки для обучения мультимодальных моделей и применяет GRPO с составными наградами. Практическое значение для конечных пользователей по источнику не раскрыто.
Как это применить
Из аннотации можно взять идеи: двухуровневый формат подписи (обзор и шаги с таймкодами), аннотирование в два прохода (сначала структура событий, затем детали шагов), набор из трёх типов наград для GRPO и добавление фактов о движении по данным о позе, когда есть сенсоры. В тексте аннотации не указана ни базовая модель, ни её размер, ни публикация кода, данных или весов, поэтому готовый инструмент из неё не следует.
Можно ли доверять
Все утверждения, самооценка авторов в аннотации препринта; независимой проверки в источнике нет. Конкретные значения метрик и отрыв от конкурентов в тексте не приведены. Лидерство заявлено только среди проверенных открытых моделей, а не среди всех открытых. Победа над Gemini 3.1 Pro относится только к PhysCapBench, а над всеми проверенными закрытыми моделями, только к Minerva-Ego по протоколу «подпись → ответ на вопрос». Из пяти бенчмарков названы лишь эти два.
Риски и подводные камни
Широкие выводы вроде «лучше закрытых моделей» делать нельзя: сравнение ограничено выбранными моделями и бенчмарками. Без цифр невозможно оценить, насколько велик отрыв. Часть фактической разметки опирается на данные о позе, которые доступны не всегда, в источнике сказано, что они добавляются «когда есть данные сенсоров». Воспроизводимость остаётся под вопросом, пока в источнике нет сведений о выпуске кода, данных и весов.