Представлен MC-Lens: как зрительно-языковые модели выбирают понятия
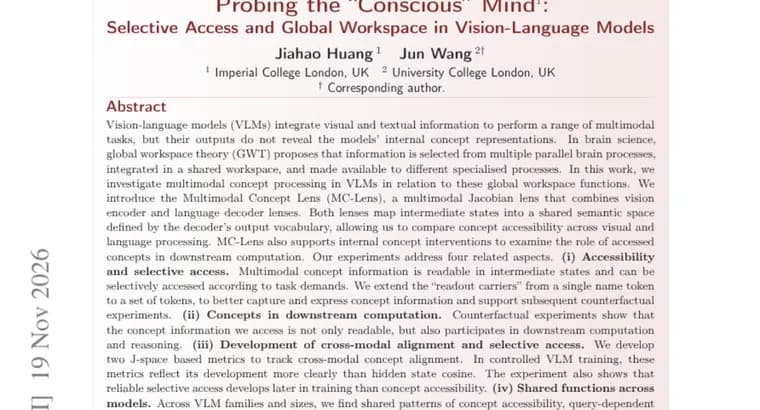
Зрительно-языковые модели (VLM) объединяют картинки и текст, но по их ответам нельзя понять, какие представления понятий возникают внутри. Чтобы заглянуть внутрь, в статье вводится Multimodal Concept Lens (MC-Lens), мультимодальная линза на основе якобиана (Jacobian lens). Исследование опирается на теорию глобального рабочего пространства (GWT): по ней информация выбирается из параллельных процессов мозга, объединяется в общем рабочем пространстве и становится доступной специализированным процессам. Авторы изучают, проявляются ли такие функции, отбор, объединение и передача, при обработке понятий в VLM.
Устройство инструмента: линзы для зрительного энкодера и языкового декодера отображают промежуточные состояния в общее семантическое пространство, заданное выходным словарём декодера. Это позволяет сравнивать доступность понятий в разных модальностях. Кроме того, MC-Lens позволяет вмешиваться во внутренние представления понятий, чтобы проверять роль «доступных» понятий в последующих вычислениях.
Результаты в аннотации сгруппированы в четыре пункта. Первый: информация о мультимодальных понятиях читается в промежуточных состояниях и избирательно доступна в зависимости от задачи; для этого «носители считывания» (readout carriers) расширили с одного токена-названия до набора токенов, что точнее выражает понятие и подходит для контрфактических экспериментов. Второй: контрфактические эксперименты показывают, что доступная информация о понятии участвует в последующих вычислениях и рассуждении. Третий: авторы разработали две метрики в J-пространстве, которые в контролируемом обучении VLM отслеживают развитие межмодального выравнивания понятий яснее, чем косинусное сходство скрытых состояний; при этом надёжный избирательный доступ формируется позже, чем сама доступность понятий. Четвёртый: у разных семейств и размеров VLM обнаружены общие закономерности, доступность понятий, зависимость избирательности от запроса и эффекты вмешательства при переходе между задачами, несмотря на различия во внутренней организации.
Вывод авторов: результаты дают экспериментальную основу для изучения GWT в мультимодальных искусственных системах и для понимания того, как эта теория может помочь улучшать межмодальное выравнивание.
Ключевые факты
- MC-Lens, мультимодальная линза на основе якобиана: линзы зрительного энкодера и языкового декодера отображают промежуточные состояния в общее семантическое пространство выходного словаря декодера.
- Информация о понятиях читается в промежуточных состояниях и избирательно доступна под задачу; контрфактические эксперименты показывают, что она участвует в последующих вычислениях и рассуждении.
- Две метрики в J-пространстве отслеживают развитие межмодального выравнивания понятий в контролируемом обучении яснее, чем косинусное сходство скрытых состояний.
- Надёжный избирательный доступ к понятиям формируется позже, чем их доступность.
- Общие закономерности найдены у разных семейств и размеров VLM, несмотря на различия во внутренней организации.
Почему это важно
По ответам зрительно-языковых моделей не видно, какие понятия представлены у них внутри. MC-Lens предлагает способ это увидеть и проверить вмешательством: читать понятия в промежуточных состояниях и менять их, наблюдая за последствиями. Заметный результат, разрыв во времени: в ходе контролируемого обучения доступность понятий появляется раньше, чем надёжный избирательный доступ к ним по запросу.
Кому это важно
Прежде всего исследователям интерпретируемости мультимодальных моделей и тем, кто занимается межмодальным выравниванием (согласованием картинки и текста). Статья также будет любопытна тем, кто сопоставляет идеи когнитивной науки, в частности теорию глобального рабочего пространства, с устройством искусственных систем.
Как это применить
Это исследовательский метод, а не готовый продукт. В аннотации описан сам подход: линзы для энкодера и декодера, вмешательства в представления понятий и две метрики в J-пространстве для наблюдения за обучением. Практически метрики предложены как более ясная замена косинусному сходству скрытых состояний при отслеживании выравнивания в контролируемом обучении VLM.
Можно ли доверять
Это препринт, и пересказ основан на его аннотации. В ней не названы авторы и организации, не указаны конкретные модели, их размеры, наборы данных и тесты, нет количественных результатов (точности, размеров эффектов, процентов). Заявления вроде «яснее, чем косинусное сходство» пока нельзя оценить в числах. Важно и то, что аннотация не утверждает, что VLM обладают сознанием или глобальным рабочим пространством: говорится лишь, что результаты дают экспериментальную основу для изучения GWT в мультимодальных системах.
Риски и подводные камни
Обращение к теории глобального рабочего пространства не стоит читать как заявление о сознании моделей: речь о проверке функций, описанных теорией. Выводы об «общих закономерностях» у разных семейств и размеров VLM нельзя перенести на конкретные модели без знания того, какие именно модели проверялись. Сравнение с другими методами интерпретации, кроме косинусного сходства скрытых состояний для метрик J-пространства, в аннотации не приводится.
«Эти результаты дают экспериментальную основу для изучения GWT в мультимодальных искусственных системах и того, как она может помочь улучшить межмодальное выравнивание.»
— из аннотации статьи