Предложен метод LSPD: дистилляция языковых моделей с позиции RL, +1,59 пункта в математике
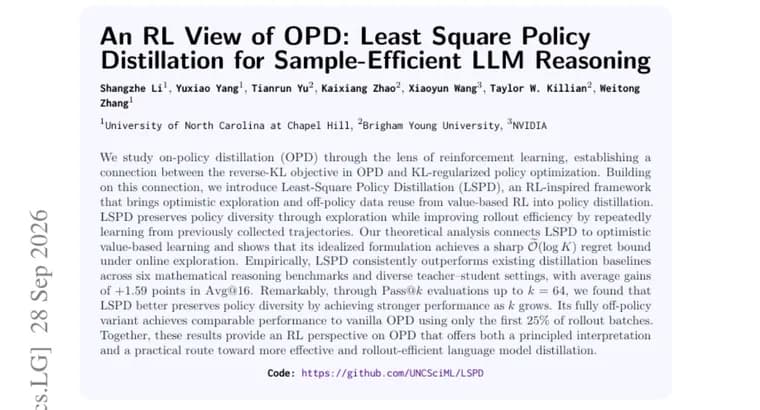
В статье на Hugging Face Papers дистилляция на собственных траекториях студента (on-policy distillation, OPD) разбирается с точки зрения обучения с подкреплением. Авторы устанавливают связь между целью обратной KL-дивергенции (reverse-KL) в OPD и оптимизацией политики с KL-регуляризацией.
На этой основе они предлагают Least-Square Policy Distillation (LSPD, дистилляцию политики методом наименьших квадратов). Это подход, вдохновлённый RL: в дистилляцию политики он переносит из RL на основе оценки ценности (value-based RL) две идеи, оптимистичное исследование и повторное использование данных, собранных другой политикой (off-policy). По утверждению авторов, LSPD сохраняет разнообразие политики за счёт исследования и одновременно повышает эффективность по числу прогонов (rollout), поскольку многократно учится на уже собранных траекториях.
Теоретическая часть связывает LSPD с оптимистичным обучением на основе оценки ценности. Авторы показывают, что идеализированная формулировка метода достигает оценки сожаления (regret) порядка O(log K) при онлайн-исследовании. Это теоретический результат, а не эмпирический.
Эмпирически, как утверждают авторы, LSPD стабильно превосходит существующие методы дистилляции на шести математических бенчмарках и в разных сочетаниях учитель-студент. Среднее преимущество составляет +1,59 пункта по метрике Avg@16 (абсолютные пункты, не проценты). Кроме того, в оценках Pass@k при k до 64 LSPD, по словам авторов, лучше сохраняет разнообразие политики: его результат растёт сильнее по мере увеличения k. Полностью off-policy вариант метода достигает результата, сопоставимого с обычным OPD, используя только первые 25% пакетов прогонов.
Итог авторов: статья даёт RL-взгляд на OPD, то есть принципиальную интерпретацию и практический путь к более эффективной и экономной по числу прогонов дистилляции языковых моделей.
Ключевые факты
- Авторы связывают цель reverse-KL в дистилляции на собственных траекториях (OPD) с оптимизацией политики с KL-регуляризацией.
- Метод LSPD переносит в дистилляцию политики оптимистичное исследование и повторное использование старых траекторий из value-based RL.
- Средний выигрыш над существующими методами дистилляции: +1,59 пункта в Avg@16 на шести математических бенчмарках и в разных парах учитель-студент.
- В Pass@k при k до 64 LSPD, по данным авторов, лучше сохраняет разнообразие: результат растёт сильнее с ростом k.
- Полностью off-policy вариант выходит на результат, сопоставимый с обычным OPD, на первых 25% пакетов прогонов; для идеализированной версии доказана оценка сожаления O(log K).
Почему это важно
Дистилляция помогает передать способности к рассуждению от сильной модели-учителя более компактной модели-студенту. В OPD студент обучается на собственных траекториях, но такие прогоны дороги. Работа предлагает взглянуть на OPD как на задачу RL. Это даёт и теоретическую интерпретацию, и способ реже собирать новые данные за счёт повторного использования старых. Выигрыш при этом скромный: в среднем +1,59 пункта Avg@16.
Кому это важно
Исследователям и инженерам, которые обучают небольшие модели для математических и других рассуждений через дистилляцию. Интересно и тем, кого волнует, как сохранять разнообразие ответов модели, которое отражают оценки Pass@k, и как экономить на числе прогонов.
Как это применить
Из доступного описания практическое применение не следует: названий моделей, размеров и самих бенчмарков в тексте нет. Как ориентир можно взять идею: собирать прогоны студента и обучаться на них повторно, поддерживая исследование. Для внедрения нужен полный текст статьи.
Можно ли доверять
Все цифры и утверждения взяты из аннотации статьи, то есть это заявления самих авторов. Независимой проверки в тексте нет. Достоверность оценки O(log K) ограничена идеализированной формулировкой метода.
Риски и подводные камни
Прирост в среднем составляет +1,59 пункта, поэтому для конкретных задач он может оказаться небольшим. Полностью off-policy вариант выходит лишь на сопоставимый с обычным OPD результат, а не на лучший. Выигрыш описан в числе пакетов прогонов, а не во времени или вычислительных затратах. Эксперименты касаются математических рассуждений, и в тексте нет данных о других областях.