ColNanoVDR сжимает кодировщик запросов для поиска по документам: до 26 раз быстрее
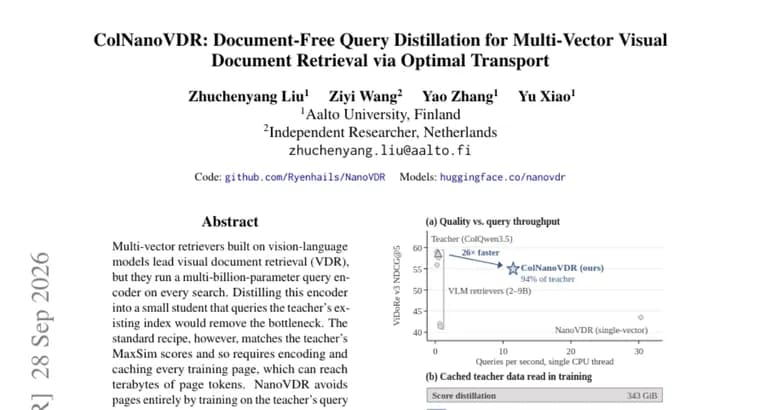
Лучшие системы поиска по визуальным документам (страницам со схемами, таблицами и текстом) строят на многовекторных ретриверах на основе визуально-языковых моделей. Их слабое место: на каждый поисковый запрос запускается кодировщик запросов размером в несколько миллиардов параметров. Идея авторов в том, чтобы обучить небольшую модель-ученика, которая работает с уже существующим индексом модели-учителя, и так убрать это узкое место.\n\nСтандартный способ дистилляции подгоняет оценки MaxSim ученика под оценки учителя. Для этого нужно закодировать и сохранить все обучающие страницы, а это, по словам авторов, может доходить до терабайт токенов страниц. Ранний метод NanoVDR обходится без страниц: он обучается только на эмбеддингах запросов учителя, но работает лишь с одновекторными ретриверами.\n\nАвторы представляют ColNanoVDR и называют его, насколько им известно, первым фреймворком, который переносит такую дистилляцию без документов на многовекторный поиск. Целевая функция OTW (Optimal Transport with Learned Weights, оптимальный транспорт с обучаемыми весами) сопоставляет токены запроса ученика с токенами запроса учителя методом энтропийного оптимального транспорта, при этом каждому токену ученика назначается обучаемый вес. Соответствие между двумя токенизациями заранее знать не нужно. Авторы доказывают, что стоимость такого сопоставления ограничивает разницу оценок MaxSim на любой странице.\n\nРезультаты: текстовые ученики на 149 млн параметров, полученные из пяти современных учителей, сохраняют около 95% NDCG@5 своих учителей на ViDoRe v1, v3 и кодируют запросы до 26 раз быстрее. При одинаковом обучении OTW сопоставим с дистилляцией по оценкам, не кодируя ни одной страницы и считывая в 12,6 раза меньше кэшированных данных учителя.
Ключевые факты
- ColNanoVDR переносит дистилляцию без документов на многовекторный поиск по визуальным документам; по мнению авторов, это первый такой фреймворк.
- Целевая функция OTW выравнивает токены запроса ученика и учителя энтропийным оптимальным транспортом с обучаемым весом на каждый токен ученика и не требует соответствия токенизаций.
- Текстовые ученики на 149 млн параметров из пяти учителей удерживают около 95% NDCG@5 учителей на ViDoRe v1, v3.
- Запросы кодируются до 26 раз быстрее, чем у учителей.
- При одинаковом обучении OTW сопоставим с дистилляцией по оценкам, но читает в 12,6 раза меньше кэшированных данных учителя.
Почему это важно
В многовекторном поиске по визуальным документам кодировщик запросов на несколько миллиардов параметров запускается при каждом обращении, и это удорожает и замедляет поиск. Работа показывает способ заменить его компактной текстовой моделью, не трогая индекс страниц учителя. Отдельно важно, что обучение не требует кодировать и хранить страницы, а такой кэш, по словам авторов, может занимать терабайты.
Кому это важно
Исследователям и инженерам, которые строят поиск по документам-изображениям на многовекторных ретриверах и хотят снизить задержку и стоимость обработки запросов. Также тем, кто занимается дистилляцией моделей поиска.
Как это применить
Пересказ построен по аннотации. Идея практическая: обучить небольшой текстовый кодировщик запросов на эмбеддингах запросов учителя и использовать его с уже построенным индексом учителя. Сведений о выпуске кода, моделей или лицензии в источнике нет, поэтому оценить готовность к использованию по нему нельзя.
Можно ли доверять
Все цифры (около 95% NDCG@5, ускорение до 26 раз, в 12,6 раза меньше считываемых данных) взяты из аннотации и являются заявлением авторов. Утверждение о первенстве дано с оговоркой «насколько нам известно». Абсолютных значений NDCG@5 в источнике нет, пять учителей не названы, а 95% дано приблизительно и без разбивки по учителям и версиям ViDoRe.
Риски и подводные камни
Ускорение «до 26 раз», максимум, а не типичное значение. Около 95% качества означает, что часть точности учителя теряется. Результаты приведены на ViDoRe v1, v3 и для пяти учителей, поэтому перенос на другие данные и модели по источнику подтвердить нельзя.