Предложена архитектура WhiteMatter: слои трансформера видят кеш любой глубины
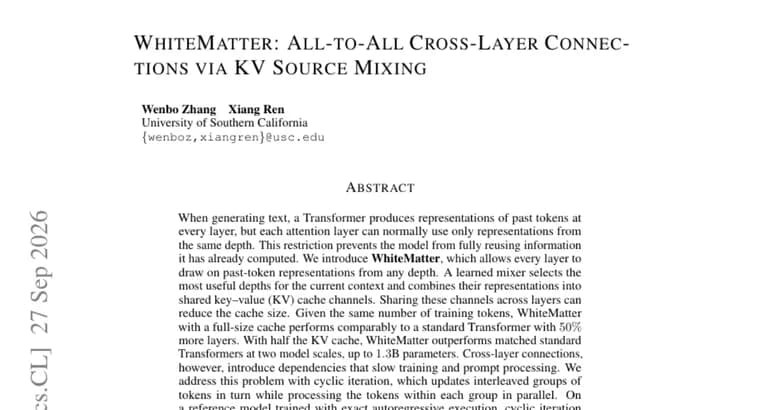
Обычный трансформер при генерации текста на каждом слое строит представления прошлых токенов, но каждый слой может использовать только представления своей же глубины. По мнению авторов статьи, из-за этого модель не может полностью переиспользовать уже вычисленную информацию.\n\nАвторы предлагают WhiteMatter: вариант трансформера, где каждый слой может обращаться к представлениям прошлых токенов с любой глубины. Обучаемый смеситель (mixer) выбирает наиболее полезные для текущего контекста глубины и объединяет их представления в общие каналы KV-кеша (ключи и значения внимания). Общие каналы, разделяемые между слоями, могут уменьшить размер кеша.\n\nРезультаты, заявленные в аннотации: при одинаковом числе обучающих токенов WhiteMatter с кешем полного размера работает сопоставимо со стандартным трансформером, у которого на 50% больше слоёв. С половиной KV-кеша WhiteMatter превосходит сопоставимые стандартные трансформеры на двух масштабах моделей, до 1,3 млрд параметров.\n\nУ межслойных связей есть цена: они создают зависимости, которые замедляют обучение и обработку промпта. Для этого авторы предлагают циклическую итерацию (cyclic iteration): она поочерёдно обновляет чередующиеся группы токенов, а токены внутри каждой группы обрабатывает параллельно. На эталонной модели, обученной с точным авторегрессивным выполнением, циклическая итерация сходится в 12,5 раза быстрее стандартной итерации Якоби.
Ключевые факты
- WhiteMatter позволяет каждому слою трансформера использовать представления прошлых токенов с любой глубины, а не только с той же.
- Обучаемый смеситель выбирает полезные глубины для контекста и сводит их в общие каналы KV-кеша, что может уменьшить его размер.
- С кешем полного размера модель сопоставима со стандартным трансформером с на 50% большим числом слоёв при равном числе обучающих токенов.
- С половиной KV-кеша WhiteMatter превосходит сопоставимые стандартные трансформеры на двух масштабах, до 1,3 млрд параметров.
- Циклическая итерация против замедления из-за межслойных зависимостей сходится в 12,5 раза быстрее итерации Якоби на эталонной модели.
Почему это важно
KV-кеш, одна из главных статей расхода памяти при генерации текста трансформерами. WhiteMatter предлагает сразу два выигрыша: возможность лучше переиспользовать уже вычисленное и заявленное сокращение кеша вдвое при сохранении качества не хуже стандартных моделей на двух масштабах до 1,3 млрд параметров. При этом авторы честно называют цену: межслойные зависимости замедляют обучение и обработку промпта, и против этого введена циклическая итерация.
Кому это важно
Исследователям архитектур трансформеров и эффективного вывода, а также тем, кто работает над сжатием KV-кеша и ускорением обучения. Практикам результат пока интересен как направление для наблюдения: проверка идёт на моделях до 1,3 млрд параметров.
Как это применить
Напрямую применять пока нечего: в тексте источника не упомянут выпуск кода или моделей. Идею стоит держать в поле зрения как вариант архитектуры с общими KV-каналами между слоями и обучаемым выбором глубин.
Можно ли доверять
Источник, аннотация статьи, и все цифры даны авторами без указания бенчмарков, наборов данных и метрик для «сопоставимо» и «превосходит». Точные размеры моделей, кроме верхней границы 1,3 млрд параметров, не приведены. Показатель 12,5x относится к эталонной модели, обученной с точным авторегрессивным выполнением, а не ко всем моделям. Авторы и организации в тексте не названы, независимой проверки нет.
Риски и подводные камни
Масштаб проверки ограничен двумя размерами до 1,3 млрд параметров, поэтому неизвестно, сохранится ли эффект у более крупных моделей. Сокращение кеша в аннотации сформулировано как возможность («может уменьшить»), измерен лишь случай с половиной кеша. Межслойные зависимости замедляют обучение и обработку промпта, а абсолютных цифр скорости и сравнения по реальному времени с обычным трансформером нет, так что итоговый выигрыш по вычислениям остаётся неясным.
«С половиной KV-кеша WhiteMatter превосходит сопоставимые стандартные трансформеры на двух масштабах моделей, до 1,3 млрд параметров.»
— Аннотация статьи о WhiteMatter