Предложен AnswerMap: метод показывает, на что смотрит визуально-языковая модель
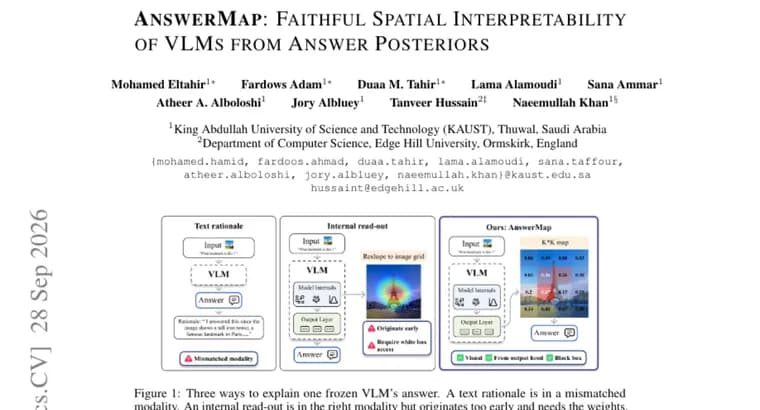
В статье представлен AnswerMap, метод интерпретации визуально-языковых моделей (VLM), которые отвечают на вопросы по картинкам. Авторы исходят из того, что существующие инструменты объяснения либо опираются на текстовые рассуждения (по их словам, это несоответствие модальностей), либо на внутренние показатели модели, которые, как пишут авторы, формируются слишком рано, чтобы отражать итоговый ответ, и к тому же требуют доступа к «внутренностям» модели (white-box).
AnswerMap не требует обучения, не привязан к конкретной задаче и работает как «чёрный ящик»: карта строится по выходной части модели. Изображение режут на K горизонтальных и K вертикальных полос. Каждую полосу по отдельности показывают замороженной модели вместе с запросом в виде вопроса «релевантна ли эта полоса запросу: да или нет». Внешнее произведение вероятностей ответа «да» по строкам и по столбцам даёт пространственную карту, зависящую от запроса. Значение K в тексте не указано.
Если поверх карты задать фиксированную функцию считывания R (например, математическое ожидание или максимум), можно получать непрерывные ответы, такие как координаты точки, не проходя через дискретные текстовые токены. По утверждению авторов, это гарантирует, что ответ зависит от изображения по построению.
Поскольку объяснение может быть «выдуманным» самой моделью, достоверность карты проверяли на четырёх моделях и трёх наборах запросов двумя тестами: совпадение с точкой, которую модель сама указывает в ответе, и удаление области карты. Карта попадает туда, куда указывает модель, с AUC 0,85 против 0,38 у внимания. Удаление области AnswerMap меняет 53% правильных ответов против 19% при удалении области, выбранной по вниманию.
Отдельно показана польза карты для разных задач через три способа считывания. Максимум карты помечает галлюцинированные объекты без генерации текста. Математическое ожидание карты правильно определяет положение объекта там, где собственное указание модели ошибается. Область с наибольшей массой карты, возвращённая модели в виде обрезанного фрагмента, исправляет половину её неверных ответов. Авторы заключают, что AnswerMap даёт новый взгляд на интерпретируемость VLM и новый интерфейс вывода для визуальных задач помимо текстовых токенов.
Ключевые факты
- AnswerMap, метод без обучения и без доступа к внутренним слоям: изображение режут на K строк и K столбцов, каждую полосу показывают модели как вопрос «да/нет» о релевантности запросу.
- Карта, внешнее произведение вероятностей ответа «да» по строкам и столбцам; поверх неё задаётся функция считывания (ожидание, максимум) для непрерывных ответов вроде координат.
- Проверка на четырёх моделях и трёх наборах запросов: совпадение с точкой модели AUC 0,85 против 0,38 у внимания; удаление области карты меняет 53% правильных ответов против 19% у внимания.
- Три применения: максимум карты выявляет галлюцинированные объекты без генерации, ожидание локализует объект при сбое указания модели, область с наибольшей массой как обрезка исправляет половину неверных ответов.
Почему это важно
Объяснить, на что именно смотрит визуально-языковая модель, сложно: текстовые пояснения могут не совпадать с реальной причиной ответа, а внутренние показатели требуют доступа к весам. AnswerMap предлагает пространственное объяснение, построенное только из ответов модели, и проверяет его на достоверность. По результатам авторов, оно заметно точнее совпадает с поведением модели, чем внимание: AUC 0,85 против 0,38.
Кому это важно
Исследователям интерпретируемости и надёжности мультимодальных моделей, а также тем, кто работает с закрытыми моделями, к внутренностям которых доступа нет: метод чёрного ящика для них применим напрямую. Интересен и тем, кто борется с галлюцинациями объектов на изображениях.
Как это применить
По описанию, достаточно разрезать изображение на K полос по строкам и по столбцам, показать каждую полосу замороженной модели с запросом как вопрос «да/нет» и перемножить вероятности «да». Дальше карту можно считывать по-разному: максимум для поиска галлюцинаций, ожидание для локализации, область с наибольшей массой как обрезку для повторного запроса. Значение K и вычислительная стоимость в тексте не указаны, кода и набора данных в описании нет.
Можно ли доверять
Источник, аннотация научной статьи; все цифры и выводы заявлены самими авторами. В аннотации не названы четыре проверенные модели и три набора запросов, неясно, усреднены ли показатели 53% и 19% и доля исправленных ответов по моделям. Независимой проверки в материале нет, поэтому результаты стоит считать предварительными.
Риски и подводные камни
Метод по сути требует множества запросов к модели на одно изображение (по полосам), а стоимость в источнике не оценена. Полосы показываются по отдельности, поэтому карта отражает реакцию модели на срезы, а не на цельную картинку. Заявленные преимущества над вниманием получены в условиях, которые в аннотации описаны кратко, так что переносимость на другие модели и задачи нужно проверять.