Предложен метод LEGO: видео от первого лица по записи со стороны без карт глубины
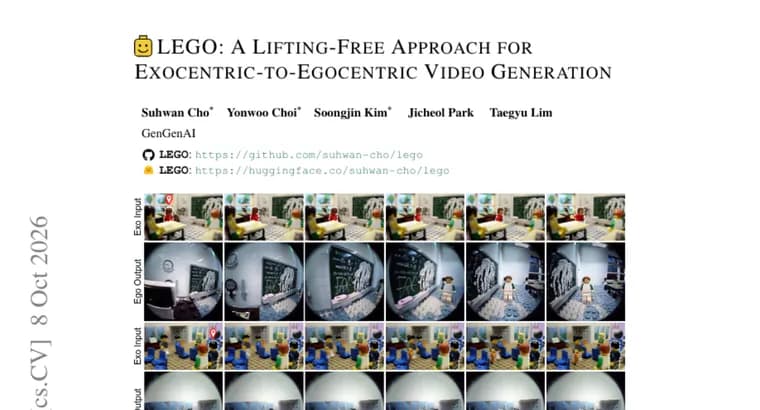
Задача, которой посвящена статья LEGO: по одной записи, снятой со стороны (экзоцентричный вид), сгенерировать видео так, как его увидел бы человек из сцены (эгоцентричный вид, от первого лица). Авторы называют это сложным случаем синтеза новых ракурсов: у двух камер почти нет общей области обзора, а значительная часть целевого кадра в исходном видео вообще не наблюдается.
По описанию авторов, нынешние лучшие методы восстанавливают сцену явно: оценивают глубину, «поднимают» видео в облако точек и заново отрисовывают его с позиции эгоцентричной камеры, а результат подают как условие видеомодели на основе диффузии. Такое детерминированное отображение привязывает каждый пиксель к одной переспроецированной точке. Текстура при этом сохраняется, но ошибки оценки глубины превращаются в неверно размещённое содержимое.
Авторы спрашивают, что именно должна получать диффузионная модель в качестве условия, и предлагают ответ без «подъёма» в трёхмерие: обученный синтезатор ракурсов, трансформер в стиле LVSM, дообученный сразу рисовать эгоцентричный вид без глубины, облаков точек и переспроецирования. Соответствие между ракурсами он разрешает внутри себя. Его отображение вероятностное: каждую область он усредняет по возможным исходным положениям в соответствии с обученным распределением соответствий. Структура сохраняется, а мелкая текстура усредняется и пропадает.
Авторы утверждают (в аннотации это довод, а не продемонстрированный результат), что такой компромисс подходит диффузионному генератору: обучение через шумоподавление хорошо восстанавливает детали, поэтому хорошее условие должно отдавать приоритет структурному совпадению, а не резкости.
Кроме того, концентрация этого распределения даёт уверенность по каждой области. Её используют двояко: маскируют области с низкой уверенностью и направляют генератор к областям с высокой уверенностью на ранних шагах шумоподавления, когда формируется общая компоновка кадра.
Итог по заявлению авторов: подход стабильно превосходит лучший явный конвейер и переносится на другие наборы данных без дообучения. Синтезатор задаёт структуру вида, диффузионная модель, детали. Количественные результаты, названия наборов данных и сравниваемого метода в тексте не приведены.
Ключевые факты
- Задача: сгенерировать видео от первого лица (эгоцентричный вид) по одной записи со стороны (экзоцентричный вид); камеры почти не пересекаются, значительная часть целевого кадра не наблюдается.
- Лучшие нынешние методы оценивают глубину, строят облако точек и перерисовывают его с эгоцентричной камеры; ошибки глубины превращаются в неверно размещённое содержимое.
- LEGO заменяет это обученным синтезатором ракурсов, трансформером в стиле LVSM, который рисует эгоцентричный вид напрямую, без глубины, облаков точек и переспроецирования.
- Усреднение по распределению соответствий сохраняет структуру, но размывает текстуру; детали добавляет диффузионная модель, а уверенность по областям служит маской и подсказкой на ранних шагах шумоподавления.
- Авторы заявляют стабильное превосходство над лучшим явным конвейером и перенос на другие наборы данных без дообучения; чисел в тексте нет.
Почему это важно
Генерация вида от первого лица из записи со стороны, трудная форма синтеза новых ракурсов, потому что исходное видео почти не показывает того, что увидела бы эгоцентричная камера. Статья предлагает другой взгляд на условие для диффузионной модели: не точную, но хрупкую трёхмерную реконструкцию, а размытую по текстуре, зато структурно согласованную картинку, к которой генератор сам добавит детали. Это отход от схемы с оценкой глубины, которую авторы называют нынешним передовым подходом.
Кому это важно
Прежде всего исследователям, работающим с синтезом новых ракурсов, видеодиффузией и эгоцентричным видео. Идея разделить роли, трансформер отвечает за структуру, диффузионная модель за детали, может пригодиться и в смежных задачах, где условие для генератора приходится получать из неполных данных. Для широкой аудитории это пока научный результат, а не готовый продукт.
Как это применить
Из текста доступна только идея метода: обучить трансформер в стиле LVSM рисовать целевой ракурс напрямую, использовать его вывод как условие для видеомодели на основе диффузии, а распределение соответствий, для получения уверенности по областям (маскирование и наведение на ранних шагах шумоподавления). Сведений о коде, весах, лицензии или стоимости в тексте нет, поэтому оценить практическую применимость сейчас нельзя.
Можно ли доверять
Это пересказ аннотации препринта, все утверждения принадлежат самим авторам. Фраза «стабильно превосходит» не подкреплена в тексте цифрами: не названы наборы данных, метрики и конкретный метод, с которым идёт сравнение. Довод о том, что компромисс между структурой и резкостью подходит диффузионному генератору, подан как аргумент авторов, а не как доказанный факт. Независимой проверки в материале нет.
Риски и подводные камни
Вероятностное усреднение по кандидатным положениям по признанию авторов размывает мелкую текстуру, поэтому качество финальных деталей целиком зависит от диффузионной модели. Из текста неясно, на каких данных обучался метод, насколько он требователен к вычислениям и как быстро работает. Утверждение о переносе на другие наборы данных без дообучения не уточнено: какие именно наборы, не сказано. До появления полной статьи с числами и сравнениями выводы стоит считать предварительными.
«Синтезатор, таким образом, задаёт структуру вида, а диффузионная модель, его детали.»
— из аннотации статьи LEGO