Метод Q&D учит ИИ-агентов самим спрашивать о недосказанном
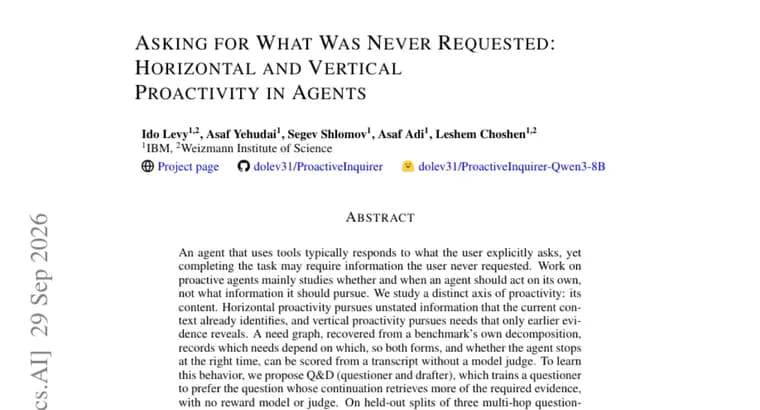
Агент, работающий с инструментами, обычно отвечает на то, о чём пользователь попросил прямо. Но для выполнения задачи часто нужна информация, которую никто не запрашивал. По словам авторов статьи, прежние работы о проактивных агентах в основном изучают, стоит ли агенту действовать самостоятельно и когда, а не то, какую информацию ему следует искать. Статья исследует другую ось проактивности, её содержание.
Авторы различают два вида. Горизонтальная проактивность, поиск недосказанной информации, которую уже определяет текущий контекст. Вертикальная проактивность, поиск потребностей, которые раскрываются только благодаря ранее найденным свидетельствам. Чтобы оценивать оба вида, используется «граф потребностей», восстановленный из собственной декомпозиции (разбиения на подзадачи) бенчмарка. Он фиксирует, какие потребности от каких зависят, поэтому по записи диалога можно оценить оба вида проактивности и то, вовремя ли агент остановился, без модели-судьи.
Для обучения такому поведению предложен метод Q&D (questioner and drafter, «вопрошатель и составитель»). Он обучает «вопрошателя» предпочитать тот вопрос, чьё продолжение извлекает больше нужных свидетельств; ни модель вознаграждения, ни судья не требуются.
Результаты, по утверждению авторов: на отложенных (не участвовавших в обучении) частях трёх бенчмарков многошагового ответа на вопросы, при равных затратах на поиск, обученный вопрошатель улучшает оба вида проактивности по сравнению с той же моделью, которой лишь дали подсказку (промпт). На двух из трёх бенчмарков он также превосходит модель в 15 раз крупнее, выполняющую ту же роль с промптом. Выигрыш сохраняется и после поправки на число и длину вопросов.
Без дополнительного обучения вопрошателя поместили в интерактивного агента службы поддержки с имитируемым клиентом: он выполняет больше задач, задавая меньше вопросов. В розничном сценарии он превосходит модель в 15 раз крупнее при меньшем числе уточняющих реплик клиента. Вывод авторов: проактивность зависит не только от того, действует ли агент без просьбы, но и от того, что он решает искать и когда останавливается.
Ключевые факты
- Авторы выделяют новую ось проактивности агентов, содержание: какую именно информацию искать, а не только когда действовать самостоятельно.
- Горизонтальная проактивность ищет недосказанное, что уже определяет текущий контекст; вертикальная, потребности, которые раскрываются лишь ранее найденными свидетельствами.
- Метод Q&D обучает вопрошателя предпочитать вопрос, продолжение которого извлекает больше нужных свидетельств, без модели вознаграждения и судьи.
- На отложенных частях трёх бенчмарков многошагового ответа на вопросы обученный вопрошатель превзошёл ту же модель с промптом, а на двух из трёх, и модель в 15 раз крупнее.
- Без дообучения в имитации службы поддержки он выполняет больше задач при меньшем числе вопросов.
Почему это важно
Обычно проактивность агента обсуждают как выбор «действовать или ждать». Статья переносит акцент на содержание: о чём именно агенту стоит спросить или что выяснить, хотя его об этом не просили. Разделение на горизонтальную и вертикальную проактивность даёт язык для такого разговора, а граф потребностей позволяет оценивать оба вида по записи диалога без модели-судьи.
Кому это важно
Разработчикам агентов, которые ведут диалог с пользователем и сами собирают недостающие данные, например, в службе поддержки или розничных сценариях. Также исследователям, которые занимаются обучением агентов и оценкой их качества без модели-судьи.
Как это применить
Из аннотации не следует готового инструмента: о выпуске кода или данных не сказано. Практические идеи, оценивать агента отдельно по горизонтальной и вертикальной проактивности, учитывать, вовремя ли он останавливается, и обучать вопросы по тому, сколько нужных свидетельств извлекает их продолжение. Вопрошателя, по словам авторов, можно перенести в агента службы поддержки без дообучения.
Можно ли доверять
Это аннотация статьи на Hugging Face; все утверждения принадлежат самим авторам и относятся к их собственному методу. Названия моделей и бенчмарков, числовые результаты и то, на каких двух из трёх бенчмарков вопрошатель обходит крупную модель, в аннотации не приведены, поэтому масштаб выигрыша оценить нельзя. Для проверки нужен полный текст статьи.
Риски и подводные камни
Заявленное превосходство над моделью в 15 раз крупнее относится лишь к двум из трёх бенчмарков и к сравнению с моделью, получившей только промпт. Результаты в службе поддержки получены с имитируемым клиентом, а не с живыми людьми, и количественно не выражены. Как поведёт себя метод в других задачах, аннотация не сообщает.
«Эти результаты показывают, что проактивность зависит не только от того, действует ли агент без просьбы, но и от того, что он решает искать и когда останавливается.»
— из аннотации статьи