Context Language Models: нейросеть сама правит свой контекст как файл
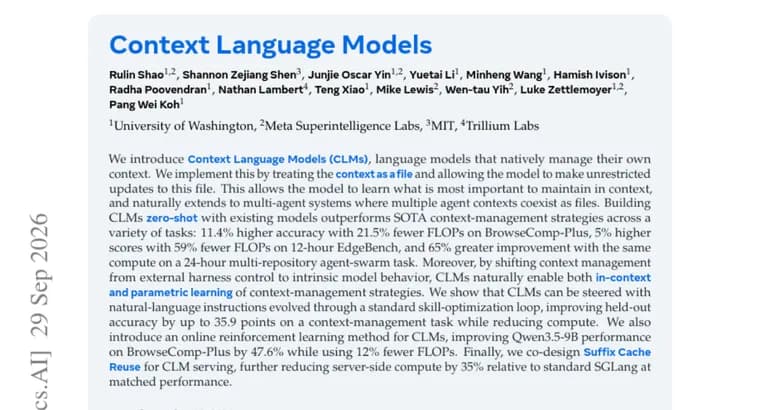
В статье представлены Context Language Models (CLM), языковые модели, которые сами управляют своим контекстом. Идея в том, что контекст рассматривается как файл, а модель может вносить в него любые изменения без ограничений. Благодаря этому она учится понимать, что важнее всего удерживать в контексте. Подход естественно переносится на мультиагентные системы: контексты нескольких агентов сосуществуют как отдельные файлы.
Авторы сообщают, что CLM, собранные без дообучения (zero-shot) на основе существующих моделей, превосходят современные (SOTA) стратегии управления контекстом на разных задачах. На BrowseComp-Plus, на 11,4% выше точность при на 21,5% меньшем числе FLOPs (операций с плавающей точкой). На 12-часовом EdgeBench, на 5% выше результат при на 59% меньшем числе FLOPs. На 24-часовой задаче роя агентов, работающих с несколькими репозиториями, на 65% большее улучшение при тех же вычислительных затратах. Указано ли, идёт ли речь о процентных пунктах или об относительном росте для 11,4% и 5%, в тексте не уточняется.
Кроме того, перенос управления контекстом с внешней обвязки на собственное поведение модели позволяет учить стратегии управления контекстом двумя способами: в контексте и через параметры модели. Авторы показывают, что CLM можно направлять инструкциями на естественном языке, которые подбираются стандартным циклом оптимизации навыков (skill-optimization loop): точность на отложенной выборке в задаче управления контекстом выросла до 35,9 пункта, а вычислений понадобилось меньше.
Также предложен метод онлайн-обучения с подкреплением для CLM: он улучшил результат Qwen3.5-9B на BrowseComp-Plus на 47,6% при на 12% меньшем числе FLOPs. Наконец, для обслуживания CLM авторы совместно разработали оптимизацию Suffix Cache Reuse, которая снижает серверные вычисления ещё на 35% относительно стандартного SGLang при том же качестве.
Ключевые факты
- CLM, языковые модели, которые сами управляют контекстом: он представлен как файл, который модель может править без ограничений.
- Без дообучения (zero-shot) на существующих моделях: на BrowseComp-Plus на 11,4% выше точность и на 21,5% меньше FLOPs; на 12-часовом EdgeBench на 5% выше результат и на 59% меньше FLOPs.
- На 24-часовой задаче роя агентов с несколькими репозиториями, на 65% большее улучшение при тех же вычислениях.
- Инструкции на естественном языке повышают точность на отложенной выборке до 35,9 пункта; онлайн-обучение с подкреплением улучшило Qwen3.5-9B на BrowseComp-Plus на 47,6% при на 12% меньшем числе FLOPs.
- Оптимизация Suffix Cache Reuse снижает серверные вычисления на 35% относительно стандартного SGLang при том же качестве.
Почему это важно
Управление контекстом, узкое место длинных агентных задач, и обычно оно вынесено во внешнюю обвязку вокруг модели. Работа предлагает перенести это управление внутрь самой модели: она сама решает, что хранить в контексте-файле, а что убрать. Заявленный выигрыш, не только в точности, но и в вычислениях: на нескольких тестах результат лучше при заметно меньшем числе FLOPs.
Кому это важно
Разработчикам агентных систем и длинных рабочих процессов с моделями, которым приходится сжимать и отбирать контекст. Также исследователям обучения с подкреплением и специалистам по обслуживанию моделей: в работе есть и метод обучения, и оптимизация серверной части.
Как это применить
Из аннотации следует, что CLM можно построить без дообучения на основе существующих моделей, а затем направлять инструкциями на естественном языке, подобранными циклом оптимизации навыков. Для более глубокой настройки предложен онлайн-метод обучения с подкреплением, а для обслуживания, Suffix Cache Reuse. Подробностей о формате файла и о том, как именно модель его обновляет, в тексте нет, а о выпуске кода или моделей ничего не сказано.
Можно ли доверять
Это собственные результаты авторов из аннотации статьи, независимой проверки в тексте нет. Авторы и организации в аннотации не названы, конкретные конкурирующие стратегии, базовые модели для zero-shot-вариантов и точка отсчёта для процентов по FLOPs не указаны. Для 11,4%, 5% и 47,6% не сказано, это пункты или относительный рост, поэтому сравнивать их между собой осторожно.
Риски и подводные камни
Цифры даны лишь в аннотации, без разбивки по условиям эксперимента. Выигрыш в 35,9 пункта указан как максимальный («до»), и относится к одной задаче управления контекстом. О том, применима ли экономия в 35% от Suffix Cache Reuse ко всем нагрузкам, не сказано. Неограниченные правки контекста самой моделью, свобода, последствия которой для надёжности в тексте не обсуждаются.