FocusVTC: метод сжатия длинного текста в картинки с адаптивным разрешением
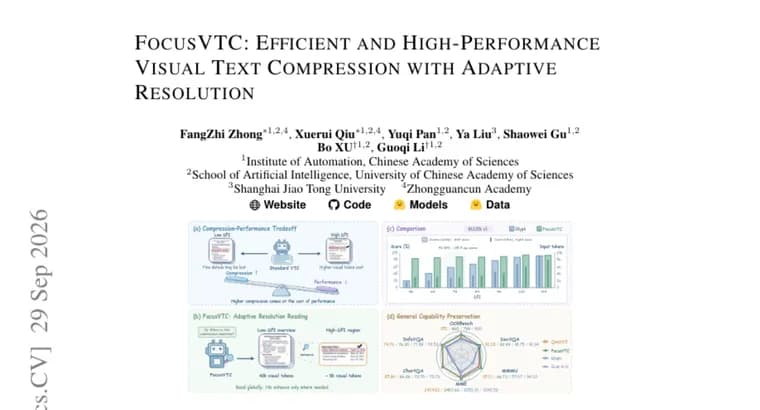
Работа посвящена визуальному сжатию текста (visual text compression, VTC): длинный вход для языковой модели превращают в изображения, чтобы сократить длину входа и расходы на вычисления и память. Проблема фиксированного разрешения, как её описывают авторы: низкий DPI экономит токены, но ухудшает читаемость, а высокий DPI тратит токены на нерелевантное содержимое.
Метод FocusVTC, по заявлению авторов, снимает этот компромисс за счёт адаптивного разрешения при сохранении общих мультимодальных способностей. Он сочетает сжатые глобальные виды в низком DPI с выборочным усилением отдельных областей, а усиленные виды встраиваются в текущее рассуждение модели.
Для обучения авторы собрали 29,4 тыс. примеров цепочек рассуждений REL-CoT (Reasoning-Evidence Localization, то есть рассуждение с локализацией свидетельств), которые связывают шаги рассуждения с номерами страниц и ограничивающими рамками (bounding boxes). Многоразрешающее обучение с учителем (REL-SFT) учит модель находить нужные области, а оптимизация Group Relative Policy Optimization учит её, когда повышать разрешение и как использовать полученные наблюдения. Отдельного этапа continual-pretraining (дополнительного предобучения) не требуется.
Результаты из аннотации. На RULER v1 при 72 DPI FocusVTC получает 87,4 при сжатии входа в 2,9 раза (с учётом наблюдений от инструментов), тогда как Glyph получает 57,5 при сжатии в 3,0 раза. На LongBench метод опережает свою базовую модель с текстовым входом: 56,40 против 55,86. Макросреднее по MRCR выросло на 13,91 пункта, на VTCBench макросреднее составило 51,19. В оценке задержки на MRCR онлайн-ускорение сквозной обработки относительно текстового входа составило 2,79 раза. Общие мультимодальные способности сохранены: MMMU выросла с 65,12 до 66,73, MME, с 2424,02 до 2457,62.
Ключевые факты
- FocusVTC рендерит длинный текст как изображения и выборочно повышает разрешение нужных областей, совмещая низкий DPI для общего вида с усилением выбранных регионов.
- Для обучения собрано 29,4 тыс. примеров REL-CoT, связывающих рассуждения со страницами и ограничивающими рамками; далее идут REL-SFT и Group Relative Policy Optimization, без отдельного этапа дополнительного предобучения.
- На RULER v1 при 72 DPI: 87,4 при сжатии входа в 2,9 раза против 57,5 у Glyph при сжатии в 3,0 раза.
- На LongBench 56,40 против 55,86 у базовой модели с текстовым входом; макросреднее по MRCR выросло на 13,91 пункта; на VTCBench 51,19.
- Онлайн-ускорение сквозной обработки на MRCR, 2,79 раза относительно текстового входа; MMMU выросла с 65,12 до 66,73, MME, с 2424,02 до 2457,62.
Почему это важно
Длинный контекст делает работу больших языковых моделей дорогой по вычислениям и памяти. Визуальное сжатие текста, один из способов уменьшить длину входа, но при фиксированном разрешении приходится выбирать между экономией токенов и читаемостью. FocusVTC предлагает обойти этот выбор: глобальный вид остаётся дешёвым, а детали подтягиваются только там, где они нужны для рассуждения.
Кому это важно
Исследователям длинного контекста и мультимодальных моделей, а также командам, которые ищут способы удешевить обработку больших документов. Результаты представлены на бенчмарках RULER v1, LongBench, MRCR, VTCBench, MMMU и MME.
Как это применить
Из аннотации видно общую схему: низкоразрешающие страницы дают общий обзор, а обученная модель сама решает, какие области показать крупнее. Обучение строится на REL-SFT на примерах REL-CoT и последующей оптимизации Group Relative Policy Optimization. Упоминаний о выпуске кода, модели или данных в аннотации нет, поэтому готового инструмента для использования она не описывает.
Можно ли доверять
Все цифры взяты из аннотации работы и подаются самими авторами; независимой проверки в материале нет. Аннотация не называет базовую модель, не указывает, что именно служит основой сравнения для прироста в 13,91 пункта по MRCR, не приводит значений других методов на VTCBench и не описывает условия замера задержки. Сравнение с Glyph на RULER v1 дано при близком, но не идентичном сжатии (2,9 раза против 3,0 раза).
Риски и подводные камни
Часть выводов нельзя оценить по одной аннотации: неясны базовая модель, абсолютное значение MRCR и оборудование для замера задержки. Прирост на LongBench небольшой (56,40 против 55,86). Метод усложняет конвейер: требуются размеченные примеры с привязкой к страницам и рамкам и обучение с подкреплением для выбора момента повышения разрешения.