EngiWorld: бенчмарк показал, что ИИ-агенты плохо справляются с инженерным ПО
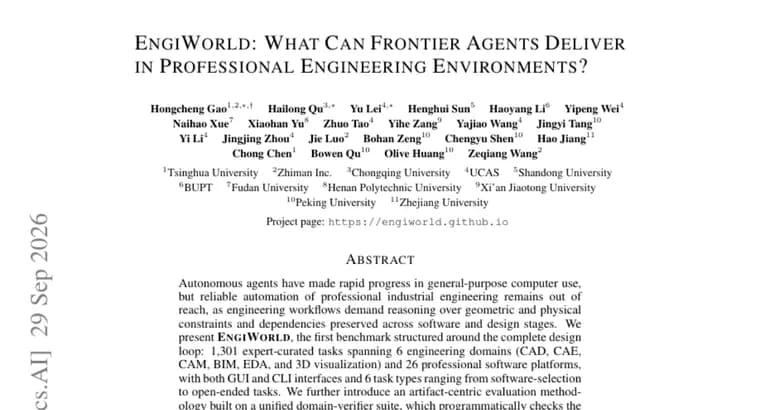
Авторы работы представили EngiWorld, бенчмарк (набор тестов) для автономных ИИ-агентов, которые должны работать в профессиональном инженерном программном обеспечении. Исходная посылка: агенты быстро продвинулись в универсальной работе с компьютером, но надёжная автоматизация профессиональной промышленной инженерии, по оценке авторов, пока недостижима. Инженерные рабочие процессы требуют рассуждать о геометрических и физических ограничениях и сохранять зависимости между разными программами и этапами проектирования.
EngiWorld, как утверждают авторы, первый бенчмарк, выстроенный вокруг полного цикла проектирования. В него входят 1301 задача, подготовленная экспертами. Они охватывают 6 инженерных областей (CAD, CAE, CAM, BIM, EDA и 3D-визуализацию) и 26 профессиональных программных платформ. Задачи рассчитаны и на графический интерфейс (GUI), и на командную строку (CLI), а типов задач шесть, от выбора программы до открытых задач.
Отдельно предложена методика оценки, ориентированная на артефакты, то есть на создаваемые агентом файлы и модели. В её основе, единый набор программных проверок по предметным областям: он автоматически проверяет геометрическую корректность, физическую осуществимость и соблюдение правил как в итоговых, так и в промежуточных артефактах. Количественные проектные задачи оцениваются непрерывно, по степени достижения спецификации, а не по принципу «выполнено / не выполнено».
Результат проверки семи передовых моделей, по словам авторов, показывает значительный разрыв в возможностях. Сильнейшая модель получила EngiScore всего 44,3, а среди попыток, требующих работы сразу в нескольких программах, успешными оказались лишь 3,6%. Авторы заключают, что EngiWorld создаёт первую строгую основу для измерения прогресса в сторону агентов, способных работать в профессиональном инженерном ПО от начала до конца.
Ключевые факты
- EngiWorld, бенчмарк из 1301 задачи, подготовленной экспертами: 6 инженерных областей (CAD, CAE, CAM, BIM, EDA, 3D-визуализация) и 26 профессиональных программных платформ.
- Задачи доступны через GUI и CLI, типов задач шесть, от выбора программы до открытых задач.
- Оценка построена на автоматических проверках геометрической корректности, физической осуществимости и соблюдения правил для итоговых и промежуточных артефактов; количественные задачи оцениваются непрерывно.
- Из семи проверенных передовых моделей лучшая набрала EngiScore 44,3 (это максимум, а не среднее).
- Успешными оказались лишь 3,6% попыток, требующих работы в нескольких программах.
Почему это важно
Большинство тестов для ИИ-агентов проверяют общую работу с компьютером. EngiWorld, по утверждению авторов, первым охватывает полный цикл проектирования в профессиональном инженерном ПО. Итог проверки, лучший EngiScore 44,3 у сильнейшей из семи моделей и 3,6% успешных многопрограммных попыток, показывает, что до надёжной автоматизации промышленной инженерии ещё далеко.
Кому это важно
Разработчикам ИИ-агентов и исследователям, которые оценивают способности моделей в узкопрофильных областях. Также тем, кто следит за тем, когда агенты смогут брать на себя задачи в САПР, инженерных расчётах, проектировании электроники и строительном моделировании (CAD, CAE, CAM, BIM, EDA).
Как это применить
Бенчмарк можно использовать как основу для измерения прогресса агентов, работающих с профессиональным инженерным ПО от начала до конца. Методика с проверкой промежуточных и итоговых артефактов и непрерывной оценкой по достижению спецификации применима и к другим инженерным задачам. Данных о том, опубликованы ли бенчмарк и код, в описании нет.
Можно ли доверять
Все выводы взяты из краткого описания работы; цифры приводятся самими авторами. Описание не называет семь проверенных моделей и не говорит, какая из них набрала 44,3. Не указана шкала EngiScore, нет результатов по областям, интерфейсам и типам задач, а также числа многопрограммных попыток. Утверждение о «первом» бенчмарке, заявление самих авторов.
Риски и подводные камни
Без шкалы EngiScore число 44,3 трудно интерпретировать. Цифра 3,6% относится только к многопрограммным попыткам, и перенести её на все задачи нельзя. Неизвестно, какие именно модели и как себя показали, поэтому делать выводы о конкретных продуктах рано.