Meta Expert: общие для слоёв эксперты MoE сравнялись с обычным MoE при 70-80% экспертов
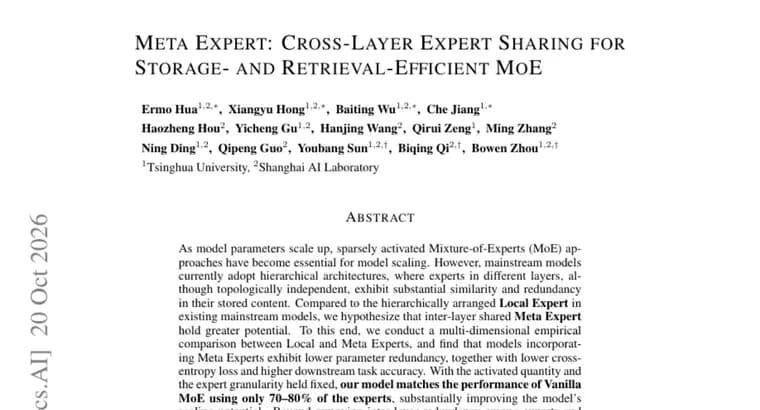
В препринте предложена архитектура Meta Expert для разреженных моделей Mixture-of-Experts (MoE, «смесь экспертов»). Исходная проблема, по описанию авторов: по мере роста числа параметров разреженно активируемые MoE стали важным способом масштабирования, но в основных современных моделях архитектура иерархическая, у каждого слоя свои эксперты. Хотя эти эксперты топологически независимы, содержимое, которое они хранят, заметно похоже и избыточно.
Авторы выдвигают гипотезу: эксперты, общие для разных слоёв (Meta Expert), перспективнее локальных экспертов (Local Expert), привязанных к своему слою. Чтобы проверить это, они провели многомерное эмпирическое сравнение локальных и общих экспертов. По их результатам, модели с Meta Expert имеют меньшую избыточность параметров, меньшую кросс-энтропийную потерю и более высокую точность на downstream-задачах (прикладных задачах после обучения). Конкретные значения метрик в аннотации не приводятся.
Главная цифра: при фиксированных числе активируемых экспертов и их гранулярности (размере) модель с Meta Expert достигает качества обычного (Vanilla) MoE, используя лишь 70-80% от числа экспертов. Авторы считают, что это существенно повышает потенциал масштабирования модели.
Кроме снятия межслойной избыточности экспертов и более эффективного хранения информации, теоретический анализ авторов, как они пишут, показывает ещё одно преимущество: по сравнению с локальными экспертами Meta Expert дают скрытым состояниям (hidden states) более гибкие остаточные пути (residual pathways), что повышает эффективность извлечения информации.
Ключевые факты
- Meta Expert, эксперты MoE, общие для разных слоёв, вместо отдельных экспертов в каждом слое (Local Expert).
- Исходное наблюдение авторов: эксперты разных слоёв в основных иерархических MoE-моделях заметно похожи и избыточны по хранимому содержимому.
- При фиксированных числе активируемых экспертов и гранулярности модель, по словам авторов, сравнивается с Vanilla MoE, используя лишь 70-80% экспертов.
- В сравнении авторов модели с Meta Expert показывают меньшую избыточность параметров, меньшую кросс-энтропийную потерю и более высокую точность на downstream-задачах.
- Теоретический анализ, по утверждению авторов, указывает на более гибкие остаточные пути для скрытых состояний и лучшую эффективность извлечения информации.
Почему это важно
MoE-подход стал одним из основных способов масштабирования больших моделей, а число экспертов напрямую влияет на объём хранимых параметров. Если эксперты разных слоёв в значительной мере дублируют друг друга, как утверждают авторы, то общий набор экспертов на все слои может дать то же качество с меньшим их числом: заявлено 70-80% от числа экспертов обычного MoE при тех же числе активируемых экспертов и гранулярности.
Кому это важно
Исследователям и инженерам, которые проектируют и обучают разреженные MoE-архитектуры и думают о том, как расходуются параметры. Остальным читателям это пока скорее сигнал о направлении исследований, чем готовый продукт.
Как это применить
Прямого практического применения в источнике не описано: это препринт с предложенной архитектурой. Код, выпуск модели и данные о вычислительных затратах на обучение в тексте не упоминаются. Практическая польза, идея для экспериментов: проверить на собственной MoE-архитектуре, насколько эксперты разных слоёв избыточны и можно ли их разделить между слоями.
Можно ли доверять
Все утверждения, слова самих авторов из аннотации, независимой проверки в источнике нет. Не названы размеры моделей, наборы данных, бенчмарки и конкретный базовый Vanilla MoE, а значения точности и кросс-энтропии не приведены, только «ниже» и «выше». Поэтому судить о весе результата по аннотации трудно; нужно читать полный текст статьи.
Риски и подводные камни
Цифра 70-80% относится к доле экспертов относительно обычного MoE при фиксированных активации и гранулярности, это не показатель точности. В тексте обсуждаются число экспертов и эффективность хранения и извлечения информации; измерений скорости вывода и потребления памяти нет. Идея общих для слоёв экспертов пока подтверждена только заявлением авторов и их теоретическим анализом.
«При фиксированных числе активируемых экспертов и гранулярности экспертов наша модель достигает качества Vanilla MoE, используя лишь 70-80% экспертов, что существенно повышает потенциал масштабирования модели.»
— из аннотации препринта Meta Expert
Компания Meta Platforms признана экстремистской организацией, её деятельность на территории РФ запрещена.