Медицинские нейросети учатся на опыте без дообучения: прирост до 34,2%
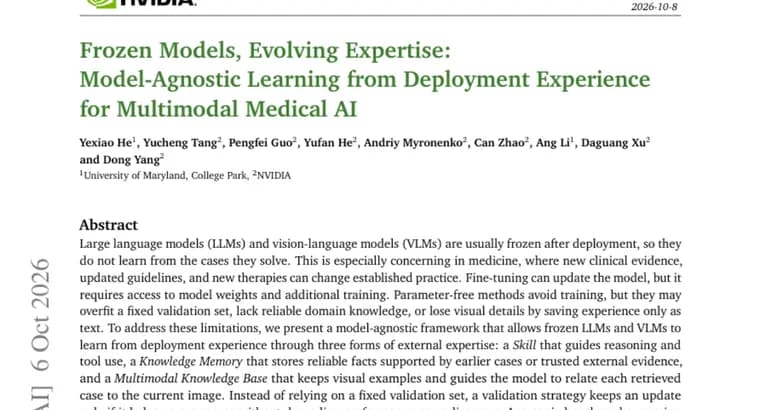
Большие языковые модели (LLM) и модели, работающие с текстом и изображениями (VLM), после развёртывания обычно остаются «замороженными»: они не учатся на случаях, которые решают. Авторы работы подчёркивают, что в медицине это особенно тревожно, поскольку новые клинические данные, обновлённые рекомендации и новые методы лечения могут менять устоявшуюся практику.
Существующие пути, по оценке авторов, имеют изъяны. Дообучение (fine-tuning) обновляет модель, но требует доступа к её весам и дополнительного обучения. Методы без изменения параметров обходятся без обучения, но могут переобучиться под фиксированную проверочную выборку, не иметь надёжных предметных знаний или терять визуальные детали, если опыт сохраняется только в виде текста.
В ответ предлагается подход, не привязанный к конкретной модели: замороженная модель учится на опыте эксплуатации через три формы внешней экспертизы. Первая, Навык (Skill), который направляет рассуждение и использование инструментов. Вторая, Память знаний (Knowledge Memory), где хранятся надёжные факты, подтверждённые прежними случаями или проверенными внешними данными. Третья, Мультимодальная база знаний (Multimodal Knowledge Base), которая хранит визуальные примеры и помогает модели соотнести каждый найденный случай с текущим изображением.
Вместо фиксированной проверочной выборки используется стратегия валидации: обновление сохраняется, только если оно помогает на новых случаях и не ухудшает результат на прежних.
Проверка шла на шести бенчмарках, охватывающих клиническую диагностику, клинические рабочие процессы, медицинские рассуждения, а также медицинское и немедицинское визуальное рассуждение, с четырьмя базовыми моделями (открытыми и закрытыми). По словам авторов, подход улучшает качество работы в ходе онлайн-эксплуатации до 34,2% по сравнению с базовой моделью на медицинских задачах, обобщается на не встречавшиеся случаи, переносится на другие модели без дополнительной оптимизации и работает в немедицинских областях.
Ключевые факты
- Подход не привязан к конкретной модели и позволяет замороженным LLM и VLM учиться на опыте эксплуатации без доступа к весам и без дополнительного обучения.
- Опыт хранится в трёх формах: Навык (Skill), Память знаний (Knowledge Memory) и Мультимодальная база знаний (Multimodal Knowledge Base) с визуальными примерами.
- Обновление принимается, только если помогает на новых случаях и не ухудшает результат на прежних; фиксированная проверочная выборка не используется.
- Проверка: шесть бенчмарков и четыре базовые модели (открытые и закрытые); прирост на медицинских задачах, до 34,2% к базовой модели.
- Авторы заявляют о переносе на другие модели без дополнительной оптимизации и о работе в немедицинских областях.
Почему это важно
Проблема, на которую указывают авторы, знакома любой системе с готовой моделью: после развёртывания она не учится на решённых случаях, а медицинская практика меняется вместе с клиническими данными, рекомендациями и методами лечения. Предложенный подход пытается закрыть этот разрыв, не трогая веса модели, то есть там, где дообучение недоступно или нежелательно.
Кому это важно
Прежде всего тем, кто строит медицинские ИИ-системы поверх готовых закрытых или открытых моделей и не имеет доступа к их весам. Идея внешней накапливаемой экспертизы также может быть интересна исследователям мультимодальных систем: по утверждению авторов, подход работает и в немедицинских областях.
Как это применить
Источник описывает идею и результаты, но не упоминает публикацию кода, наборов данных или моделей, поэтому готового инструмента для использования из текста не следует. Практический вывод на уровне концепции: опыт можно накапливать не в весах, а в трёх внешних компонентах, навыке, памяти фактов и базе визуальных примеров, и принимать обновления только после проверки на новых и прежних случаях.
Можно ли доверять
Все цифры и выводы, заявления самих авторов; независимой проверки в тексте нет. Пересказ основан на кратком изложении работы (аннотации). Цифра 34,2%, максимальная («до»): источник не уточняет, в процентных пунктах или относительно она выражена и на каком бенчмарке и какой модели получена. Результаты по отдельным бенчмаркам и моделям, а также типичный прирост не приведены, конкретные модели и бенчмарки не названы.
Риски и подводные камни
Из текста не следует, что подход проверялся в клинической эксплуатации: клиническое внедрение, регуляторное одобрение и тесты на реальных пациентах не упоминаются. Заявленный максимум в 34,2% не говорит о типичном выигрыше. Сам принцип накопления опыта также зависит от качества проверки обновлений: авторы предлагают для этого специальную стратегию валидации, но оценить её надёжность по доступному тексту нельзя.