Исследователи предложили U-Space: карту неуверенности языковой модели по токенам
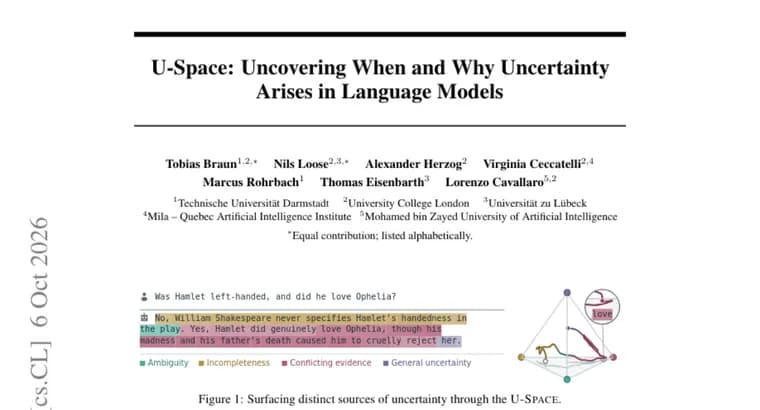
Авторы исходят из того, что языковые модели всё чаще участвуют в решениях с высокой ценой ошибки, а сами модели могут подавать неверные выводы гладкими объяснениями и уверенным тоном. Поэтому важно уметь оценивать надёжность отдельного ответа и понимать, когда лучше отказаться от доверия к нему. Существующие методы количественной оценки неуверенности, по словам авторов, часто требуют повторных генераций или отдельно обучаемых компонентов, а их скалярные оценки не показывают, где именно возникает неуверенность и как она меняется по ходу рассуждения. Кроме того, ранее было показано, что длина генерации может быть сильно связана и с оценками неуверенности, и с правильностью ответа. Отсюда вопрос: какая доля предсказательной силы оценщика приходит от информации именно о неуверенности, а не от одной лишь длины вывода.
В ответ авторы вводят U-Space, низкоразмерное подпространство остаточного пространства (residual space) модели, которое делает меняющуюся неуверенность измеримой и интерпретируемой. Построение выглядит так: сначала находятся смысловые «якоря» сомнения и уверенности, затем их направления в выходной матрице (unembedding) переносятся обратно в остаточное пространство, а контрасты между ними объединяются в ортогональный базис.
Инструмент U-Lens проецирует состояние каждого токена на векторы этого базиса. На выходе получается карта неуверенности по токенам, которую можно разглядывать напрямую или свернуть в один скалярный балл неуверенности.
По утверждению авторов, подход не требует ни меток правильности ответов, ни повторных генераций, ни обучения. На бенчмарках по рассуждению его балл уверенности превосходит устоявшиеся базовые методы как при стандартной оценке, так и при оценке с контролем длины ответа, а также переносится надёжнее, чем оценщики, обученные с учителем. Код опубликован на GitHub: github.com/s2labres/U-Space.
Ключевые факты
- U-Space, низкоразмерное подпространство остаточного пространства модели, построенное из смысловых «якорей» сомнения и уверенности и ортогонального базиса из их контрастов.
- U-Lens проецирует состояние каждого токена на этот базис и даёт карту неуверенности по токенам либо один скалярный балл уверенности.
- Метод, по заявлению авторов, не требует меток правильности, повторных генераций и обучения.
- Авторы утверждают, что балл превосходит устоявшиеся базовые методы на бенчмарках по рассуждению, в том числе при контроле длины ответа, и переносится надёжнее оценщиков с обучением с учителем.
- Код опубликован: github.com/s2labres/U-Space.
Почему это важно
Языковые модели участвуют во всё более ответственных решениях, а их ошибки подаются с беглыми объяснениями и авторитетным тоном, поэтому сложно понять, когда ответу нельзя доверять. Существующие методы оценки неуверенности, по словам авторов, часто требуют повторных генераций или отдельно обученных компонентов и не показывают, где именно по ходу рассуждения возникает неуверенность. U-Space пытается закрыть этот пробел: он даёт карту по токенам и при этом, как утверждается, обходится без обучения и разметки. Отдельно авторы поднимают проблему длины: она может сильно коррелировать с оценками неуверенности и правильностью, поэтому они проверяют метод в том числе при контроле длины.
Кому это важно
Исследователям, которые занимаются количественной оценкой неуверенности и механистической интерпретируемостью, а также тем, кто строит системы на языковых моделях и хочет понимать, в какие моменты рассуждения модель «сомневается». Для практиков главное в заявлении авторов, отсутствие требований к разметке, повторным запускам и дополнительному обучению.
Как это применить
Код опубликован на GitHub: github.com/s2labres/U-Space. Из описания метода следует, что он работает с внутренними состояниями модели (остаточное пространство и направления в выходной матрице), то есть предполагает доступ к ним. Результатом может быть либо карта неуверенности по токенам для ручного разбора, либо один скалярный балл, который можно использовать как оценку уверенности в ответе. Какие модели и настройки поддерживаются, в тексте не сказано, это стоит проверить в репозитории.
Можно ли доверять
Все утверждения о превосходстве над базовыми методами и о лучшем переносе исходят от самих авторов. В тексте не названы авторы и организации, бенчмарки, модели и их размеры, сами базовые методы, а также нет числовых результатов и величины отрыва. Не указаны площадка публикации и статус рецензирования. Код открыт, поэтому заявления в принципе можно проверить самостоятельно.
Риски и подводные камни
В описании нет ограничений и случаев, где метод не работает. Не сказано, какая часть выигрыша над базовыми методами сохраняется при контроле длины: известно лишь, что метод превосходит их при обеих схемах оценки. Без названий бенчмарков, моделей и чисел нельзя судить, насколько заметен выигрыш и переносится ли он на другие модели и задачи вне рассуждений. Метод опирается на внутренние состояния модели, поэтому, судя по описанию, он неприменим там, где к ним нет доступа.
«Наш подход не требует ни меток правильности, ни повторных генераций, ни обучения.»
— Авторы статьи, из аннотации