Memento 3: агент на замороженной LLM прошёл 25 публичных игр ARC-AGI-3
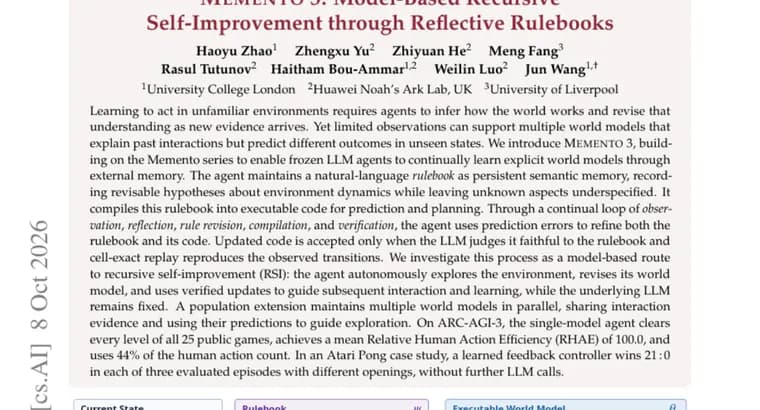
Препринт описывает Memento 3, продолжение серии Memento. Идея: агент на замороженной языковой модели (LLM), то есть такой, чьи веса не меняются, постоянно учится явным моделям мира с помощью внешней памяти. Отправная проблема, как её формулируют авторы: ограниченные наблюдения допускают сразу несколько моделей мира, которые одинаково хорошо объясняют прошлые взаимодействия, но дают разные прогнозы в ещё не виденных состояниях.
Устройство агента. Он ведёт свод правил на естественном языке, это постоянная семантическая память с пересматриваемыми гипотезами о динамике среды; неизвестные аспекты в нём намеренно остаются неопределёнными. Затем свод правил компилируется в исполняемый код, который используется для предсказания и планирования. В непрерывном цикле «наблюдение, рефлексия, пересмотр правил, компиляция, проверка» агент использует ошибки предсказания, чтобы уточнять и свод правил, и код. Обновлённый код принимается только при двух условиях сразу: LLM считает его соответствующим своду правил, и воспроизведение (replay) с точностью до клетки повторяет наблюдавшиеся переходы.
Авторы изучают этот процесс как путь к рекурсивному самосовершенствованию (RSI), основанный на модели мира: агент самостоятельно исследует среду, пересматривает модель мира и использует проверенные обновления для дальнейшего взаимодействия и обучения, а сама LLM остаётся неизменной. Отдельное расширение, «популяция»: несколько моделей мира поддерживаются параллельно, делятся данными о взаимодействии, а их предсказания направляют исследование.
Результаты, заявленные в аннотации. На ARC-AGI-3 агент с одной моделью проходит все уровни всех 25 публичных игр, получает среднюю относительную эффективность действий по сравнению с человеком (Relative Human Action Efficiency, RHAE) 100,0 и тратит 44% от числа действий человека. В демонстрационном примере с Atari Pong обученный контроллер с обратной связью выигрывает со счётом 21:0 в каждом из трёх оценённых эпизодов с разными началами игры и делает это без дополнительных вызовов LLM.
Ключевые факты
- Memento 3 позволяет агенту на замороженной LLM непрерывно учить явную модель мира через внешнюю память: свод правил на естественном языке компилируется в исполняемый код для предсказания и планирования.
- Правки принимаются только после проверки: LLM должна признать код соответствующим своду правил, а воспроизведение с точностью до клетки должно повторить наблюдавшиеся переходы.
- На ARC-AGI-3 агент с одной моделью, по заявлению авторов, проходит все уровни всех 25 публичных игр, средняя RHAE равна 100,0, а число действий составляет 44% от человеческого.
- В примере с Atari Pong обученный контроллер выигрывает 21:0 в каждом из трёх эпизодов с разными началами, без дополнительных вызовов LLM.
- Процесс рассматривается как модельный путь к рекурсивному самосовершенствованию (RSI) при неизменной LLM; расширение «популяция» держит несколько моделей мира параллельно.
Почему это важно
Работа предлагает способ, при котором агент учится на опыте, не меняя весов языковой модели: знание о мире хранится в виде свода правил и компилируется в код, который можно проверить на реальных наблюдениях. Это отвечает на проблему неоднозначных моделей мира при малом числе наблюдений: гипотезы пересматриваются по ошибкам предсказания, а неизвестное остаётся неопределённым. Заявленный результат, полное прохождение 25 публичных игр ARC-AGI-3 при 44% от числа действий человека, сильный, но это результат препринта.
Кому это важно
Исследователям ИИ-агентов и обучения в интерактивных средах, тем, кто работает с ARC-AGI-3, и тем, кого интересуют модели мира и рекурсивное самосовершенствование без дообучения базовой модели. Также полезно разработчикам агентов, которым нужна проверяемая память: схема «текстовые правила плюс исполняемый код» отличается от хранения опыта в виде логов.
Как это применить
Из аннотации можно взять архитектурную схему: вести свод правил на естественном языке, компилировать его в код для предсказания и планирования, а правки принимать только при двойной проверке, соответствие своду правил по оценке LLM и точное воспроизведение наблюдавшихся переходов. В аннотации не упомянут выпуск кода, модели или данных, поэтому готового инструмента для запуска по этому тексту не видно.
Можно ли доверять
Это аннотация препринта, и все цифры, заявления авторов; независимой проверки в тексте нет. В аннотации не названы авторы и организации, не указана используемая LLM и не приведены базовые сравнения с другими агентами на ARC-AGI-3, так что положение результата относительно других систем из неё не понять. Не объяснена и шкала RHAE за пределами сообщённого среднего значения 100,0.
Риски и подводные камни
Не сказано, составляют ли 25 публичных игр весь бенчмарк и есть ли результаты на закрытом или отложенном наборе. Не указаны затраты: число вызовов LLM, токены, время работы. Для расширения «популяция» приведено только описание конструкции, без результатов. Пример с Pong, один демонстрационный случай из трёх эпизодов, более широких результатов по Atari в тексте нет. Наконец, рекурсивное самосовершенствование здесь изучается как направление, а не заявлено как достигнутое.