COAP: в статье предложили управлять роботом одним кодом, без VLA и VLM
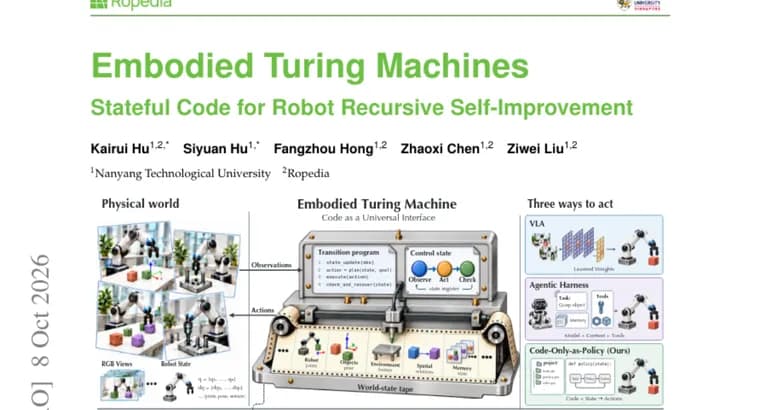
Большинство роботизированных политик держат модель прямо в контуре управления: VLA (модель «зрение, язык, действие») переводит наблюдения в действия, а Agent Harness (агентная обвязка), например Agent-as-Policy или Harness VLA, во время работы запрашивает VLM (визуально-языковую модель) для принятия решений. Авторы статьи предлагают другой взгляд: воплощённый мир, это «воплощённая машина Тьюринга» (Embodied Turing Machine), где лента, это состояние робота и среды, а правила, это политика.
Если это состояние удаётся представить точно, принятие решений можно целиком записать в коде. Отсюда подход Code-Only-as-Policy (COAP): код по изображениям с камер и проприоцептивным данным (внутренним датчикам самого робота) измеряет и отслеживает состояние робота, среды и задачи и принимает из него каждое решение. Один и тот же код применяется во всех эпизодах, а разные задачи делят одну библиотеку, причём ни VLM, ни VLA в контуре нет.
В сравнении с VLA и Agent Harness авторы разбирают три преимущества COAP. Первое, явное состояние: его можно хранить прямо в коде. Второе, исполнение: код делает принятие решений управляемым, позволяет гибко восстанавливаться после сбоев и быстро и дёшево работает онлайн. Третье, расширяемость: новые задачи переиспользуют, наследуют или расширяют общую библиотеку, поэтому возможности накапливаются от задачи к задаче.
Эти свойства, по мнению авторов, делают COAP подходящей средой для рекурсивного самоулучшения (RSI): кодирующие агенты развивают библиотеку в замкнутом цикле, а каждое изменение остаётся явным и контролируемым. На 42 двуручных задачах бенчмарка RoboDojo получившаяся библиотека достигает успешности 70,24% без модели на этапе тестирования.
Авторы сами указывают предел подхода: верхняя граница COAP определяется тем, насколько точно состояние представлено для принятия решений и насколько надёжна логика кода. COAP предлагается как новая парадигма для воплощённых задач; поскольку код применим во всех эпизодах, он может служить и эффективным генератором данных (data engine) для VLA и Agent Harness.
Ключевые факты
- COAP (Code-Only-as-Policy): все решения робота принимает код, который по изображениям с камер и проприоцептивным данным отслеживает состояние робота, среды и задачи; VLM и VLA в контуре нет.
- Авторы называют три преимущества подхода: явное состояние, исполнение (управляемость, гибкое восстановление после сбоев, быстрая и дешёвая работа онлайн) и расширяемость общей библиотеки.
- Кодирующие агенты развивают библиотеку в замкнутом цикле, и каждое изменение остаётся явным и контролируемым, так авторы описывают рекурсивное самоулучшение (RSI).
- На 42 двуручных задачах RoboDojo итоговая библиотека достигает успешности 70,24% без модели на этапе тестирования.
- Предел подхода, по словам авторов, задают точность представления состояния и надёжность логики кода; COAP может также служить генератором данных для VLA и Agent Harness.
Почему это важно
Работа ставит под вопрос привычную схему, где в контуре управления робота обязательно стоит большая модель. Авторы утверждают, что при точном представлении состояния решения можно записать целиком в коде, а модель нужна лишь на этапе разработки этого кода. Если это сработает шире, чем показано в статье, управление роботом станет явным, проверяемым и дешёвым в исполнении. Пока это идея и один результат на одном бенчмарке.
Кому это важно
Исследователям и инженерам в робототехнике, которые строят политики на основе VLA или агентных обвязок вокруг VLM, а также тем, кто изучает кодирующих агентов и рекурсивное самоулучшение. Интересно и тем, кого заботят управляемость и стоимость исполнения решений на роботе.
Как это применить
Из аннотации не следует готового рецепта внедрения. Практическая идея в том, чтобы вынести принятие решений в код, который отслеживает состояние по камерам и проприоцептивным данным, держать задачи в одной общей библиотеке и поручать её развитие кодирующим агентам в замкнутом цикле. Авторы также предлагают использовать COAP как генератор данных для VLA и Agent Harness.
Можно ли доверять
Источник, аннотация научной статьи, все утверждения принадлежат её авторам. Цифра 70,24% на 42 двуручных задачах RoboDojo получена самими авторами на выбранном бенчмарке. Базовые показатели VLA и Agent Harness на RoboDojo в аннотации не приведены, поэтому сравнить 70,24% не с чем. Не указано, проводились ли испытания в симуляции или на физических роботах, а также какие кодирующие агенты и модели использовались. Результатов самого цикла самоулучшения (число итераций, прирост на каждой) в аннотации тоже нет.
Риски и подводные камни
Авторы прямо оговаривают, что потолок подхода задают точность представления состояния и надёжность логики кода. Заявленные преимущества (управляемость, быстрое и дешёвое исполнение, накопление возможностей) в аннотации сформулированы как анализ, а числовых данных о скорости или стоимости исполнения она не содержит. Результат 70,24% означает, что около 30% выполнений неуспешны, а перенос на другие бенчмарки и задачи в аннотации не показан.
«Если это состояние можно представить точно, принятие решений можно целиком записать в коде.»
— из аннотации статьи «Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement»