Крошечный адаптер LoRA поднял точность Qwen3-8B с 15,5% до 99% на цепочках ссылок
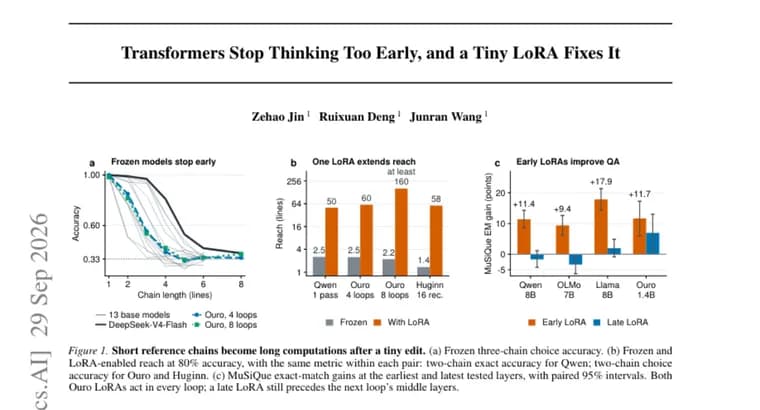
В статье с Hugging Face Papers (запись 2609.36585) утверждается, что предобученные трансформеры используют мало своей глубины, когда прослеживают ссылки в контексте. Тринадцать базовых моделей надёжно проходят лишь 1,4, 3,6 строки цепочки ссылок, а дополнительные предобученные циклы (loops) почти ничего не добавляют.
Авторы показывают, что это ограничение можно сдвинуть крошечной правкой. Адаптер LoRA ранга 8, обученный под задачу и поставленный в одном раннем слое, продлевает такие вычисления при полностью замороженных весах модели. Qwen3-8B на цепочках из 24 строк улучшает точное совпадение (exact accuracy) с 15,5% до 99%, а дольше обученный адаптер доводит длину цепочки до 50 строк. Ouro-1.4B доходит до 60 строк после четырёх циклов и как минимум до 160 после восьми.
Механизм описан как эстафета: адаптер запускает передачу, при которой строки программы передают дальше идентичность своей цепочки через короткий диапазон средних слоёв. Замороженные головы внимания читают всё дальше вверх по цепочке, а если убрать внимание к родительской строке, эстафета останавливается. Измерение на замороженной модели определяет последний полезный для вмешательства слой в пределах допуска в трёх из четырёх отложенных моделей (held-out). Адаптеры, обученные под конкретную задачу, также улучшают результат на MuSiQue.
Вывод авторов: ответы по умолчанию занижают вычисления, которые доступны через крошечную правку. Код и интерактивная демонстрация размещены на странице проекта lunamos.github.io/stop-thinking-too-early.
Ключевые факты
- Тринадцать базовых моделей надёжно следуют только по 1,4, 3,6 строки цепочки ссылок; дополнительные предобученные циклы дают мало.
- Адаптер LoRA ранга 8 в одном раннем слое при замороженных весах поднимает точное совпадение Qwen3-8B на 24-строчных цепочках с 15,5% до 99%; дольше обученный адаптер достигает 50 строк.
- Ouro-1.4B доходит до 60 строк после четырёх циклов и минимум до 160 после восьми.
- По описанию авторов, адаптер запускает «эстафету» через короткий диапазон средних слоёв; без внимания к родительской строке она останавливается.
- Адаптеры под конкретную задачу улучшают результат и на MuSiQue; код и демонстрация опубликованы.
Почему это важно
Результат намекает, что стандартные ответы моделей могут занижать то, на что способна их глубина. Если одна небольшая правка в раннем слое переводит Qwen3-8B с 15,5% на 99% точного совпадения на 24-строчных цепочках, значит, часть «потолка» связана не с нехваткой весов, а с тем, как слои используются по умолчанию. Это довод авторов; он опирается на измерения, описанные в аннотации.
Кому это важно
Исследователям интерпретируемости и архитектур трансформеров, а также тем, кто изучает циклические модели вроде Ouro-1.4B и дообучение с помощью LoRA. Практикам интересно, что правка действует при замороженных весах.
Как это применить
Прямой инструкции по применению в аннотации нет. Авторы сообщают, что код и интерактивная демонстрация доступны на странице проекта lunamos.github.io/stop-thinking-too-early, оттуда можно воспроизвести эксперименты. Какой именно ранний слой использовался, в источнике не указано.
Можно ли доверять
Это краткая аннотация, и все цифры, это заявления авторов статьи. Независимой проверки в тексте нет. В источнике не названы авторы и организации, не приведены данные по MuSiQue (сказано лишь, что результат улучшается), не перечислены все тринадцать моделей и не описан формат задачи сверх «строк программы» в цепочках ссылок. Метод проверен на цепочках ссылок; в тексте не сказано, переносится ли он на общие рассуждения или практические задачи.
Риски и подводные камни
Главный риск, переоценить обобщаемость: 99% относятся к цепочкам из 24 строк, и об остальных задачах известно лишь, что адаптеры для конкретной задачи улучшают MuSiQue. Адаптер обучается под задачу, то есть это не бесплатное улучшение для любой модели. Измерение, определяющее последний полезный слой для вмешательства, сработало в пределах допуска лишь в трёх из четырёх отложенных моделей.