Бенчмарк PhysVista показал: визуально-языковые модели слабо понимают физику
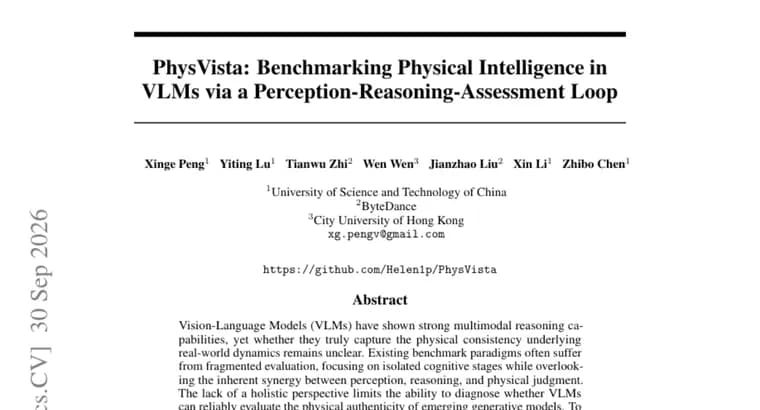
Визуально-языковые модели (VLM) демонстрируют сильные мультимодальные рассуждения, но остаётся неясным, схватывают ли они физическую согласованность, лежащую в основе динамики реального мира. Авторы работы отмечают, что существующие бенчмарки часто страдают от фрагментарности: они проверяют отдельные когнитивные этапы и упускают взаимосвязь между восприятием, рассуждением и физической оценкой. Из-за отсутствия целостного взгляда трудно понять, могут ли VLM надёжно судить о физической достоверности видео, созданных новыми генеративными моделями.
В ответ они представили PhysVista, бенчмарк для оценки физического интеллекта VLM через замкнутый когнитивный цикл, вдохновлённый человеческим процессом «увидеть, осмыслить, оценить». Бенчмарк совместно проверяет три вещи: восприятие физического состояния, рассуждение о физической динамике и оценку физической правдоподобности. Кроме того, он разделяет рассуждения на уровне событий и на уровне масштаба, что позволяет детальнее анализировать физическое понимание.
В PhysVista входят как реальные, так и сгенерированные ИИ видео, поэтому оценку можно проводить в разных предметных областях и на материале новых генеративных сценариев.
Широкие эксперименты на разнообразном наборе VLM выявили существенные ограничения в физических рассуждениях и оценке правдоподобия. По словам авторов, это указывает на устойчивый разрыв между визуальным распознаванием и подлинным физическим пониманием и подсказывает более принципиальные подходы к созданию мультимодального ИИ, опирающегося на физику.
Ключевые факты
- PhysVista, бенчмарк физического интеллекта визуально-языковых моделей на основе замкнутого цикла «увидеть, осмыслить, оценить».
- Он совместно проверяет восприятие физического состояния, рассуждение о физической динамике и оценку физической правдоподобности.
- Рассуждения разделены на уровень событий и уровень масштаба для более тонкого анализа.
- В набор входят реальные и сгенерированные ИИ видео.
- Эксперименты выявили существенные ограничения моделей и разрыв между распознаванием и физическим пониманием.
Почему это важно
Модели хорошо описывают, что видно на кадре, но неясно, понимают ли они физику происходящего. Авторы указывают на конкретную проблему существующих тестов: те проверяют отдельные этапы по отдельности. PhysVista пытается оценить восприятие, рассуждение и суждение о правдоподобии вместе, а заодно проверить, способны ли такие модели оценивать физическую достоверность видео от генеративных систем.
Кому это важно
Прежде всего исследователям мультимодальных моделей и авторам бенчмарков, которым нужна диагностика физического понимания. Работа также интересна тем, кто думает об использовании VLM для проверки реалистичности сгенерированного видео.
Как это применить
Из описания видно, что PhysVista можно использовать как набор для сравнения VLM по трём этапам цикла и по двум уровням рассуждений (событийному и масштабному). Данных о размере набора, ссылках на код и датасет в описании нет, поэтому детали использования нужно смотреть в самой статье.
Можно ли доверять
Это краткое описание (аннотация) научной работы, выводы приведены в формулировках самих авторов. Названий протестированных моделей, численных результатов и размера бенчмарка в тексте нет, поэтому оценить масштаб выявленных слабостей по этим данным нельзя.
Риски и подводные камни
Вывод о «существенных ограничениях» дан без цифр и без списка моделей, так что сравнивать его с другими работами трудно. Результат относится к конкретному бенчмарку и его способу постановки задач; как он переносится на другие тесты и практические задачи, из описания не видно.