Дистилляция предпочтений: меньшие модели дают лучшие отвергнутые ответы
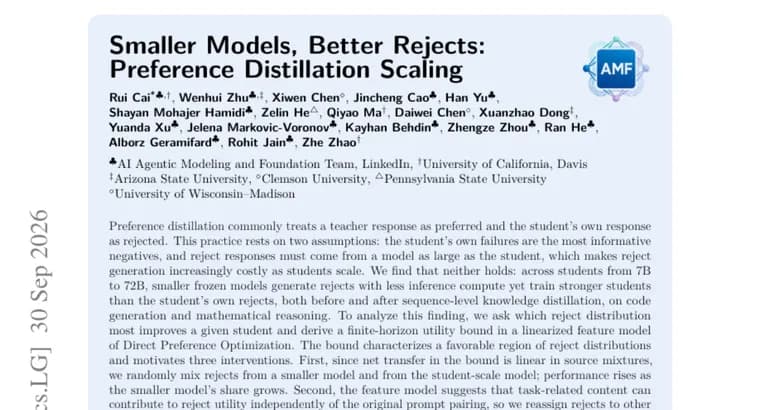
Обычно при дистилляции предпочтений ответ модели-учителя считают «предпочтительным», а ответ самого ученика, «отвергнутым». За этим стоят два допущения: собственные ошибки ученика, самые информативные негативные примеры, а отвергнутые ответы должны исходить от модели не меньше ученика, из-за чего генерация дорого обходится в масштабе.
Авторы статьи пишут, что ни одно из допущений не подтверждается. На учениках размером от 7B до 72B меньшие замороженные модели генерируют отвергнутые ответы с меньшими затратами на вывод, но обучают более сильных учеников, чем собственные отвергнутые ответы ученика. Это наблюдается и до, и после дистилляции на уровне последовательностей, на задачах генерации кода и математических рассуждений.
Для объяснения авторы выводят оценку полезности для метода Direct Preference Optimization (DPO) на конечном горизонте в линеаризованной модели признаков. Оценка описывает, какие распределения отвергнутых ответов выгодны, и подсказывает три вмешательства.
Первое: смешивание отвергнутых ответов от меньших моделей и моделей масштаба ученика улучшает результат по мере роста доли меньшей модели. Второе: отвергнутые ответы, переназначенные другим запросам и с перемешанными токенами кода, всё равно превосходят бессмысленный набор символов той же длины, то есть структура задачи вносит вклад в полезность отвергнутых ответов. Третье: выбор кандидатов с меньшим правдоподобием по опорной политике улучшает итоговый перенос, когда кандидаты с большим правдоподобием дают менее полезный контраст; выборки с меньшим правдоподобием превосходят выборки с большим для каждого источника.
Вывод авторов: эффективные отвергнутые ответы сохраняют структуру задачи и при этом слабо связаны с опорной политикой, а меньшие замороженные модели могут давать такие ответы дёшево.
Ключевые факты
- Меньшие замороженные модели генерируют отвергнутые ответы с меньшими затратами на вывод, но обучают более сильных учеников, чем самогенерируемые отвергнутые ответы; наблюдение сделано на учениках от 7B до 72B.
- Результат получен на генерации кода и математических рассуждениях, до и после дистилляции на уровне последовательностей.
- Теоретическое объяснение, оценка полезности DPO на конечном горизонте в линеаризованной модели признаков; она подсказывает три вмешательства.
- Структура задачи важна: отвергнутые ответы, переназначенные другим запросам и с перемешанными токенами кода, всё равно превосходят бессмысленный набор символов той же длины.
- Кандидаты с меньшим правдоподобием по опорной политике работают лучше кандидатов с большим правдоподобием, для каждого источника.
Почему это важно
Распространённая практика дистилляции предпочтений предполагает, что лучшие негативные примеры, собственные ошибки ученика, а генерировать их должна крупная модель. Авторы утверждают, что оба допущения неверны. Если это подтвердится, отвергнутые ответы можно получать от более мелких моделей с меньшими затратами на вывод, не теряя в качестве ученика.
Кому это важно
Исследователям и командам, которые обучают модели на предпочтениях, особенно для генерации кода и математических рассуждений, а также тем, кого ограничивает стоимость генерации отвергнутых ответов в больших объёмах.
Как это применить
Из статьи следуют три направления. Брать отвергнутые ответы у меньших замороженных моделей или смешивать их с ответами моделей масштаба ученика, увеличивая долю меньших. Сохранять структуру задачи в отвергнутых ответах. Выбирать кандидатов с меньшим правдоподобием по опорной политике. Конкретные модели, наборы данных и настройки в источнике не названы.
Можно ли доверять
Это краткое описание статьи (аннотация); все выводы принадлежат самим авторам. В источнике нет ни числовых результатов (прироста точности, экономии вычислений, оценок на бенчмарках), ни названий конкретных моделей и наборов данных, ни имён авторов и организаций. Независимой проверки результатов в материале нет.
Риски и подводные камни
Теоретическая оценка выведена в линеаризованной модели признаков, а не для реальных полноразмерных сетей; авторы лишь пишут, что результаты «указывают» на описанный механизм. Размер меньших моделей и объём сэкономленных вычислений не указаны. Эксперименты охватывают генерацию кода и математические рассуждения, поэтому перенос на другие задачи в источнике не показан. О публикации кода, моделей или данных не упомянуто.
«Мы обнаруживаем, что ни одно из этих допущений не выполняется.»
— из аннотации статьи