JEV-as-a-Judge: дешёвый ИИ-судья почти не уступает топовым LLM в оценке ответов
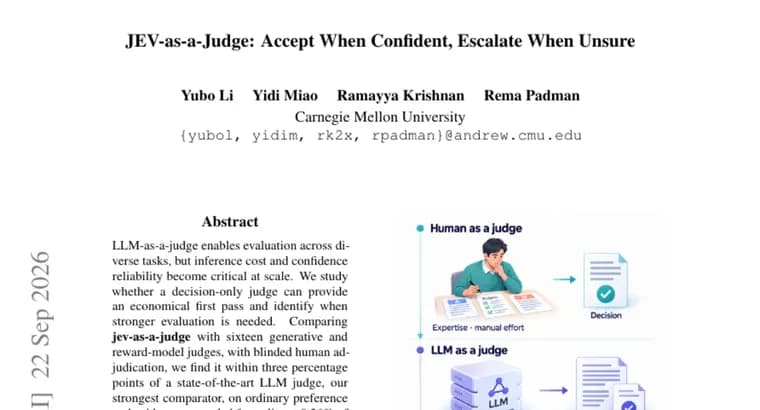
Учёные изучили, может ли простой «судья принятия решений» (decision-only judge) под названием JEV (jev-as-a-judge) служить дешёвым первым фильтром при оценке ответов языковых моделей, и самостоятельно определять, когда решение нужно передать более сильному и дорогому судье. JEV сравнили с шестнадцатью генеративными и reward-model судьями с помощью слепой оценки людьми-разметчиками (blinded human adjudication). На задачах обычного сравнения предпочтений и проверки фактов с опорой на источники (evidence-grounded factuality) JEV отстал от лучшего LLM-судьи, самого сильного из сравниваемых, всего на три процентных пункта, при этом его использование обошлось в 0,36% стоимости этого судьи. Разрыв в точности заметно увеличивается, когда для оценки нужно проверить ход вывода (деривацию) или распознать искусно написанный, но неверный ответ. На нескольких бенчмарках этот разрыв концентрируется именно в случаях, где JEV сам не уверен в своём решении. Опираясь на это наблюдение, авторы построили «застывший» (frozen) каскад: JEV принимает уверенные вердикты самостоятельно, а неуверенные передаёт («эскалирует») более сильному судье. Такая схема сохраняет 99% точности сильного судьи-компаратора при заметно меньших затратах.
Ключевые факты
- JEV (jev-as-a-judge), экономичный судья, принимающий только решение, без развёрнутого объяснения; его сравнили с 16 генеративными и reward-model судьями через слепую оценку людьми
- На задачах сравнения предпочтений и проверки фактов JEV отстаёт от лучшего LLM-судьи лишь на 3 процентных пункта, но стоит 0,36% от его цены
- Разрыв в точности растёт на задачах, где нужно проверить ход вывода или распознать убедительно написанный неверный ответ
- На части бенчмарков ошибки JEV концентрируются в случаях, где сам судья не уверен в вердикте
- Каскад «принять уверенный вердикт, эскалировать неуверенный к сильному судье» сохраняет 99% точности эталонного судьи при более низких затратах
Почему это важно
Схема LLM-как-судья (LLM-as-a-judge) стала стандартным способом массово оценивать ответы моделей, но при масштабировании критичными становятся стоимость инференса и надёжность уверенности судьи. Работа показывает, что дешёвый судья, принимающий только решение (без развёрнутого объяснения), может почти догнать по точности лучшие и намного более дорогие генеративные судьи, если правильно использовать его уверенность как сигнал для эскалации.
Кому это важно
Прежде всего командам, которые строят пайплайны оценки качества ответов ИИ-моделей в промышленных масштабах, там, где счёт оценок идёт на тысячи и миллионы, а вызов дорогого судьи на каждый случай экономически невыгоден.
Как это применить
Практический вывод исследования, каскадная схема: сначала прогонять ответы через дешёвого судью JEV, и только те случаи, где он выдаёт низкую уверенность, передавать на повторную оценку более сильному и дорогому LLM-судье. По данным авторов, это сохраняет 99% точности эталонного судьи при кратно меньших затратах (JEV стоит 0,36% от цены сравниваемого топового судьи).
Можно ли доверять
Сравнение проводилось со слепой оценкой людьми-разметчиками (blinded human adjudication) против шестнадцати генеративных и reward-model судей, что говорит в пользу методической строгости. При этом в доступном тексте не указаны ни авторы или организация-разработчик, ни расшифровка аббревиатуры JEV, ни конкретные названия использованных бенчмарков, это стоит учитывать при оценке результатов.
Риски и подводные камни
Главная слабость JEV, задачи, требующие проверки хода рассуждения (деривации) или распознавания элаборированного, убедительно составленного, но неверного ответа: именно здесь разрыв с топовыми судьями заметно увеличивается. Это ограничивает применимость дешёвого судьи для сложных задач, где нужна глубокая проверка логики, а не только сравнение предпочтений.