Исследователи предложили AEWM, модель мира, которая редактирует рассуждения ИИ-агента вместо предсказания среды
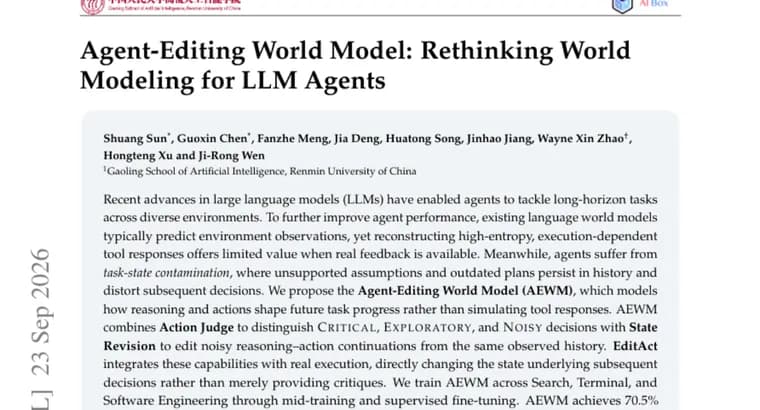
Авторы работы отмечают: существующие языковые модели мира для ИИ-агентов обычно пытаются предсказывать будущие наблюдения среды, то есть ответы инструментов и внешних систем. Но такие ответы часто высокоэнтропийны и зависят от конкретного выполнения, поэтому их реконструкция даёт мало пользы, когда агент и так может получить реальную обратную связь от среды. Вместо этого агенты страдают от другой проблемы, «заражения состояния задачи» (task-state contamination): неподтверждённые предположения и устаревшие планы остаются в истории рассуждений агента и искажают последующие решения.
Чтобы решить эту проблему, авторы предлагают Agent-Editing World Model (AEWM), модель, которая моделирует не будущие ответы инструментов, а то, как рассуждения и действия агента влияют на прогресс по задаче. AEWM состоит из двух частей: Action Judge классифицирует решения агента на «критические», «исследовательские» и «шумные» (Critical, Exploratory, Noisy), а State Revision редактирует шумные продолжения цепочки «рассуждение-действие», опираясь на ту же наблюдаемую историю. Обе способности объединены в компоненте EditAct, который работает вместе с реальным выполнением действий и напрямую меняет состояние, лежащее в основе последующих решений агента, а не просто выдаёт критику постфактум.
AEWM обучали на трёх доменах, Search (поиск), Terminal (работа в терминале) и Software Engineering (разработка ПО), с помощью промежуточного обучения (mid-training) и последующей контролируемой тонкой настройки. На собственном бенчмарке Action Judge модель достигла 70,5% macro-F1, что на 10,6 балла выше сильнейшего из сравниваемых передовых базовых решений. На шести бенчмарках и трёх различных агентных «каркасах» (backbones) EditAct повышает средний балл на 3,2, 6,7 пункта по сравнению с сильнейшим базовым решением. Кроме того, версия AEWM-RFT, дообученная методом rejection sampling на проверенных траекториях EditAct, превосходит подход Self-RFT на 2,2, 2,6 балла по трём доменам, причём уже без онлайн-подсказок от самой AEWM во время работы.
Ключевые факты
- Agent-Editing World Model (AEWM) редактирует историю рассуждений и действий агента вместо предсказания будущих ответов среды и инструментов
- AEWM состоит из Action Judge (классифицирует решения на критические, исследовательские и шумные) и State Revision (правит шумные шаги истории); вместе они образуют компонент EditAct
- На собственном бенчмарке Action Judge модель получила 70,5% macro-F1, на 10,6 балла выше сильнейшего сравниваемого базового решения
- На шести бенчмарках и трёх агентных каркасах EditAct даёт прирост среднего балла на 3,2, 6,7 пункта; AEWM-RFT превосходит Self-RFT на 2,2, 2,6 балла по трём доменам
- Модель обучена на доменах Search, Terminal и Software Engineering через промежуточное обучение и контролируемую тонкую настройку
Почему это важно
Большинство языковых моделей мира для ИИ-агентов пытаются заранее предсказать, что ответит среда или инструмент на действие агента. Авторы указывают, что это часто бесполезно: реальный ответ можно просто получить, а его предсказание, высокоэнтропийная и ненадёжная задача. Куда более серьёзная проблема, устаревшие предположения и планы, которые накапливаются в истории рассуждений агента и сбивают его с толку на поздних шагах. AEWM предлагает лечить именно эту болезнь, редактировать историю, а не гадать о будущем.
Кому это важно
Прежде всего это интересно исследователям и разработчикам агентных систем на основе больших языковых моделей, тем, кто строит агентов для долгих многошаговых задач (поиск информации, работа в терминале, автоматизация разработки ПО) и сталкивается с деградацией качества решений из-за накопления ошибок в истории диалога с инструментами.
Как это применить
EditAct описан как компонент, который можно встроить в агентный пайплайн вместе с реальным выполнением действий: он не просто оценивает шаги задним числом, а напрямую переписывает состояние истории, на основе которого агент принимает следующие решения. Отдельно показан путь дообучения, AEWM-RFT, использующий rejection sampling по проверенным траекториям EditAct, что позволяет закрепить улучшения без постоянного онлайн-участия самой AEWM.
Можно ли доверять
Текст источника, это описание (аннотация) научной работы на HuggingFace Papers, без указания авторов, организаций и даты публикации. Все приведённые цифры, 70,5% macro-F1, прирост на 3,2, 6,7 и 2,2, 2,6 балла, заявлены самими авторами по итогам собственных экспериментов; независимой проверки нет. Названия шести бенчмарков, трёх агентных каркасов и «сильнейшего базового решения», с которым идёт сравнение, в тексте не раскрываются, как и детали объёма вычислений и размера модели.
Риски и подводные камни
Поскольку конкретные бенчмарки, базовые модели для сравнения и параметры обучения не названы, результаты сложно воспроизвести или проверить сторонним наблюдателям. Улучшения представлены в узком числовом диапазоне (несколько процентных пунктов) на трёх доменах, Search, Terminal и Software Engineering, и пока неясно, насколько подход обобщается на другие типы агентных задач за пределами протестированных.
«Агенты страдают от «заражения состояния задачи»: неподтверждённые предположения и устаревшие планы сохраняются в истории и искажают последующие решения.»
— из текста статьи