Исследователи представили HarnessVLN, агента для навигации роботов без обучения
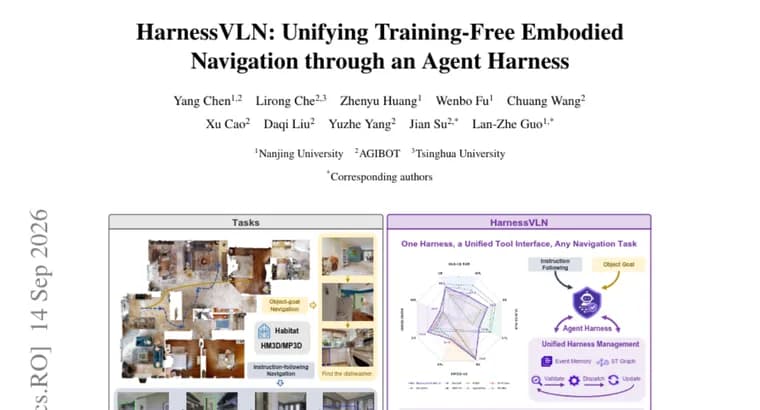
Роботу, который должен выполнять навигацию, идти по словесной инструкции или искать конкретный объект в помещении, нужно одновременно читать визуальную картинку, накапливать знания о пространстве вокруг себя и превращать всё это в действия. Обучаемые под конкретную задачу системы решают это, но плохо переносятся на новые условия. Альтернатива, методы без обучения (training-free), которые для планирования действий используют готовые мультимодальные большие языковые модели (MLLM). Проблема таких методов, по словам авторов: у них обычно нет механизма, который сверял бы предложенное моделью действие с реальными пространственными данными, ходом выполнения задачи и уже случившимися неудачами.
HarnessVLN, как раз такой механизм: обучения под конкретную среду он не требует (zero-shot, training-free), а весь процесс собирает вокруг единого компонента, так называемого Agent Harness («агентного каркаса»). Он координирует через общий интерфейс инструментов шесть этапов: восприятие, поиск, привязку к местности, собственно навигацию, восстановление после сбоя и завершение задачи. Ключевая функция каркаса, проверять предложения планировщика на соответствие пространственным данным, геометрической выполнимости и логике промежуточных подцелей, и учитывать результат этой проверки в следующих решениях. За память отвечают два модуля: иерархическая память событий отслеживает ход задачи и историю действий, а постоянный пространственно-временной граф хранит переиспользуемые пространственные данные и записи о прошлых неудачах, для проверки решений и восстановления после ошибок. Превращает уже проверенную цель в конкретное движение отдельный, заменяемый модуль, исполнитель навигации (Navigation Executor); благодаря этому один и тот же протокол каркаса подходит и для навигации по инструкции, и для поиска объекта по названию.
На четырёх бенчмарках навигации HarnessVLN показал долю успешных попыток 60,8% (R2R), 53,9% (RxR), 76,0% (HM3D-v2) и 59,3% (HM3D-OVON), по заявлению авторов, это превосходит прежние лучшие результаты среди методов без обучения. Отдельно авторы протестировали систему на гуманоидном роботе в реальной среде и утверждают, что она подходит для обеих задач, и навигации по инструкции, и поиска объекта, не только в симуляции.
Ключевые факты
- HarnessVLN, фреймворк для навигации роботов без обучения под конкретную среду (zero-shot, training-free), построенный поверх мультимодальных больших языковых моделей.
- Центральный компонент, Agent Harness: через единый интерфейс инструментов координирует восприятие, поиск, привязку к местности, навигацию, восстановление после сбоя и завершение задачи, сверяя действия планировщика с пространственными данными и их выполнимостью.
- Иерархическая память событий отслеживает ход задачи, а постоянный пространственно-временной граф хранит пространственные данные и записи о неудачах для восстановления после ошибок.
- Заменяемый модуль-исполнитель навигации переводит проверенную цель в движение, поэтому один протокол каркаса покрывает и навигацию по инструкции, и поиск объекта.
- На бенчмарках R2R, RxR, HM3D-v2 и HM3D-OVON доля успешных попыток составила 60,8%, 53,9%, 76,0% и 59,3% соответственно, по словам авторов, лучше прежних training-free решений; систему также опробовали на гуманоидном роботе в реальной среде.
Почему это важно
Методы навигации без обучения под конкретную среду ценны тем, что не требуют дорогого дообучения под каждую новую задачу или помещение, достаточно готовой мультимодальной модели. Но у них была слабость: модель предлагает действие, а свериться с тем, что реально видно в пространстве, с ходом задачи и с уже случившимися сбоями, было особо нечем. HarnessVLN нацелен именно на эту сверку, и, по заявлению авторов, это даёт заметный прирост результата на стандартных тестах навигации по сравнению с прежними training-free подходами.
Кому это важно
Работа адресована исследователям embodied AI и робототехники, которые занимаются автономной навигацией, как в симуляции на стандартных бенчмарках, так и на реальных роботах, включая гуманоидных. Полезна она и тем, кто строит агентные системы поверх готовых мультимодальных моделей и ищет архитектурные решения для проверки действий агента, а не только для их генерации.
Как это применить
У проекта есть отдельная страница (harnessvln.netlify.app) с материалами. Сам текст источника не сообщает об открытой публикации кода, лицензии или инструкции по установке, поэтому судить о готовности решения к повторному использованию по одному только описанию нельзя. Архитектурно система собрана из заменяемых частей, в частности, исполнитель навигации можно менять под конкретную платформу, что и позволило авторам перенести один и тот же каркас с бенчмарков на гуманоидного робота.
Можно ли доверять
Материал, препринт, опубликованный на HuggingFace Papers (16 отметок, 2 комментария на момент публикации); в самом тексте нет ни имён авторов, ни их организации, ни указания на рецензирование или публикацию в журнале/на конференции. Все цифры в пересказе, это заявления самих авторов о результатах их собственной системы на стандартных бенчмарках, независимой проверки или рецензии по доступному тексту не видно.
Риски и подводные камни
Успехи 60,8, 76,0% означают, что в 24, 39% попыток система задачу не выполняет, цифра сама по себе не говорит о том, где именно и почему происходят такие сбои. Числового значения «прежнего лучшего результата среди training-free методов», с которым сравнивают HarnessVLN, в тексте нет, сравнение приходится принимать на слово авторов. Детали испытания на гуманоидном роботе, какая платформа, какая конкретно среда и задачи, в тексте не раскрыты, поэтому судить о переносимости результата в реальный мир по одному абзацу преждевременно.