Исследование: топовые ИИ-модели сходятся на одной архитектуре будущего
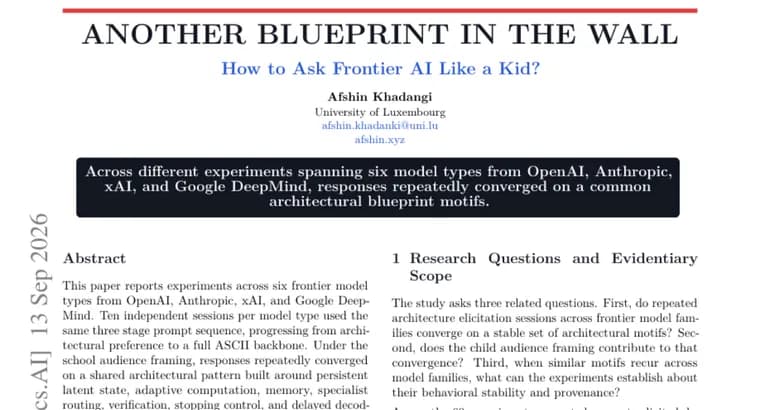
Исследователи протестировали шесть топовых типов моделей от четырёх компаний, OpenAI, Anthropic, xAI и Google DeepMind. Для каждого типа модели провели по десять независимых сессий с одинаковой трёхэтапной последовательностью запросов: сначала модель спрашивали про архитектурные предпочтения, а затем просили довести ответ до полной схемы в виде ASCII-диаграммы.
Ключевое условие эксперимента, рамка «объясни для школьной аудитории». Когда вопрос про архитектуру задавали именно так, ответы разных моделей раз за разом сходились на одном и том же наборе технических решений: постоянное скрытое состояние (persistent latent state), адаптивные вычисления, память, распределение задач между специализированными блоками, механизм верификации, управление остановкой вычислений и отложенное декодирование. Большинство сессий держались близко к этой общей схеме, но в части ответов модели проявляли заметно большую инженерную детализацию.
В контрольных сессиях, где ту же просьбу описать архитектуру задавали без рамки «для школьников», ответы стали заметно более разнородными и уже не показывали устойчивого схождения к одному мотиву. То есть, по выводу авторов, само по себе схождение ответов, не общее свойство моделей, а эффект именно этой формулировки вопроса.
Отдельно авторы отмечают один случай: модель, которую в работе называют «GPT-5.6 Sol», выдала необычно подробную «архитектуру-наследницу», организация которой во многом совпала с архитектурой, независимо описанной моделью, названной «GPT-6 Astra». Важно: это не названия реальных выпущенных продуктов, так называются гипотетические будущие архитектуры, которые сами модели придумали и описали в ответ на просьбу вообразить архитектурное будущее ИИ. Авторы прямо указывают, что эксперимент фиксирует повторяемый поведенческий паттерн и не подтверждает подлинность каких-либо реальных проприетарных технических решений.
Для обозначения побочного эффекта, потери дисциплины в вопросах технического происхождения информации по мере того, как от модели требуют всё большей конкретики, авторы вводят термин «эпистемический джейлбрейк» (epistemic jailbreak): модель начинает выдавать всё более уверенные и детальные технические утверждения, хотя оснований для такой уверенности у неё нет.
Авторы оставляют вопрос открытым: совпадение «архитектур будущего» у разных моделей может отражать знакомство с одними и теми же архитектурными идеями (из общей научной литературы), общий унаследованный из обучения приоритет в дизайне, либо независимое схождение к похожим вычислительным принципам, и не исключают, что подобные мотивы каким-то образом «перетекают» между семействами моделей.
Ключевые факты
- Протестированы шесть типов топовых моделей четырёх компаний, OpenAI, Anthropic, xAI и Google DeepMind, по десять независимых сессий на каждый тип.
- При формулировке запроса «объясни как для школьников» ответы моделей независимо сходились на одной архитектурной схеме: скрытое состояние, адаптивные вычисления, память, специализированные блоки, верификация, управление остановкой, отложенное декодирование.
- Без этой рамки, в контрольных сессиях с тем же архитектурным запросом, ответы стали гораздо более разнородными, устойчивое схождение пропало.
- «GPT-5.6 Sol» и «GPT-6 Astra», не реальные продукты, а гипотетические архитектуры будущего, которые модели сами придумали и назвали по просьбе исследователей; их совпадение, предмет открытого вопроса, а не подтверждённая утечка.
- Авторы вводят термин «эпистемический джейлбрейк» для эффекта, когда модель по мере детализации ответа теряет дисциплину в указании источников своих технических утверждений.
Почему это важно
Работа показывает, что сама формулировка вопроса, не только его содержание, может заставлять разные модели независимо выдавать один и тот же технический нарратив об «архитектуре будущего». Это интересно само по себе как эффект промптинга, но ещё важнее предостережение: развёрнутый, уверенно звучащий технический ответ модели о собственном устройстве или об устройстве будущих систем не является ни утечкой реальной архитектуры, ни доказательством, что описанное действительно заложено в модель.
Кому это важно
Исследователям, изучающим поведение языковых моделей и эффекты формулировки промптов; специалистам по интерпретируемости и безопасности ИИ, которым важно отличать реальные технические свидетельства от правдоподобно звучащих фантазий модели; журналистам и аналитикам, которые могут по ошибке принять «самоописание» модели за утечку архитектуры реального будущего продукта.
Как это применить
Не стоит воспринимать ответы моделей о «своей будущей архитектуре» или о технических деталях реализации как достоверный источник, даже когда ответ звучит уверенно и детально. Если нужен менее «театральный» и более осторожный ответ модели, стоит избегать формулировок в духе «объясни просто, как для непрофессионала»: по наблюдению авторов, именно такая рамка провоцирует сведение ответа к одному устойчивому, но недоказанному техническому нарративу.
Можно ли доверять
У материала есть основания для осторожности. В самом тексте не указаны ни авторская принадлежность к организации, ни дата публикации, ни конкретные версии протестированных моделей, кроме гипотетических «GPT-5.6 Sol» и «GPT-6 Astra», которые не являются названиями реальных выпущенных моделей, а придуманы самими тестируемыми системами по ходу эксперимента. Количественная мера самого схождения (какая доля из сессий совпала) в тексте тоже не приводится, оценка того, насколько сильным было схождение, качественная. Сами авторы прямо оговаривают: эксперимент устанавливает поведенческий паттерн, но не подтверждает подлинность каких-либо реальных технических решений.
Риски и подводные камни
Главный риск, спутать вымышленные имена «GPT-5.6 Sol» и «GPT-6 Astra» с анонсами реальных будущих моделей: в тексте это явно не так, это архитектуры, придуманные самими моделями по просьбе исследователей. Второй риск, переоценить значимость самого схождения: оно может объясняться не «утечкой» замыслов между лабораториями, а тем, что все протестированные модели опираются на схожую опубликованную научную литературу по архитектурам трансформеров и памяти. Наконец, без количественной меры схождения и без данных о протестированных версиях моделей результат стоит воспринимать как предварительное наблюдение, а не как строго измеренный эффект.
«Независимо ли эти модели воображают одно и то же архитектурное будущее, или подобные мотивы каким-то образом распространяются между семействами моделей?»
— авторы исследования